Forschungsbericht · überarbeitet am 09. November 2026
Die Auswahl aus dem kritischen Rechenweg nehmen
Die Ausgangsreferenz hält bereits eine aktive Summe pro Lane in einem Register. Weitere Kontexte werden bei Bedarf über SRAM ausgetauscht. Ein erster Vier-Kontext-Entwurf speicherte dagegen vier Summen direkt in Registern und wählte die benötigte Summe vor jeder FMA aus. Diese Auswahl verlängerte den kritischen Pfad. Der neue Kandidat untersucht deshalb eine andere Organisation derselben vier Kontexte.
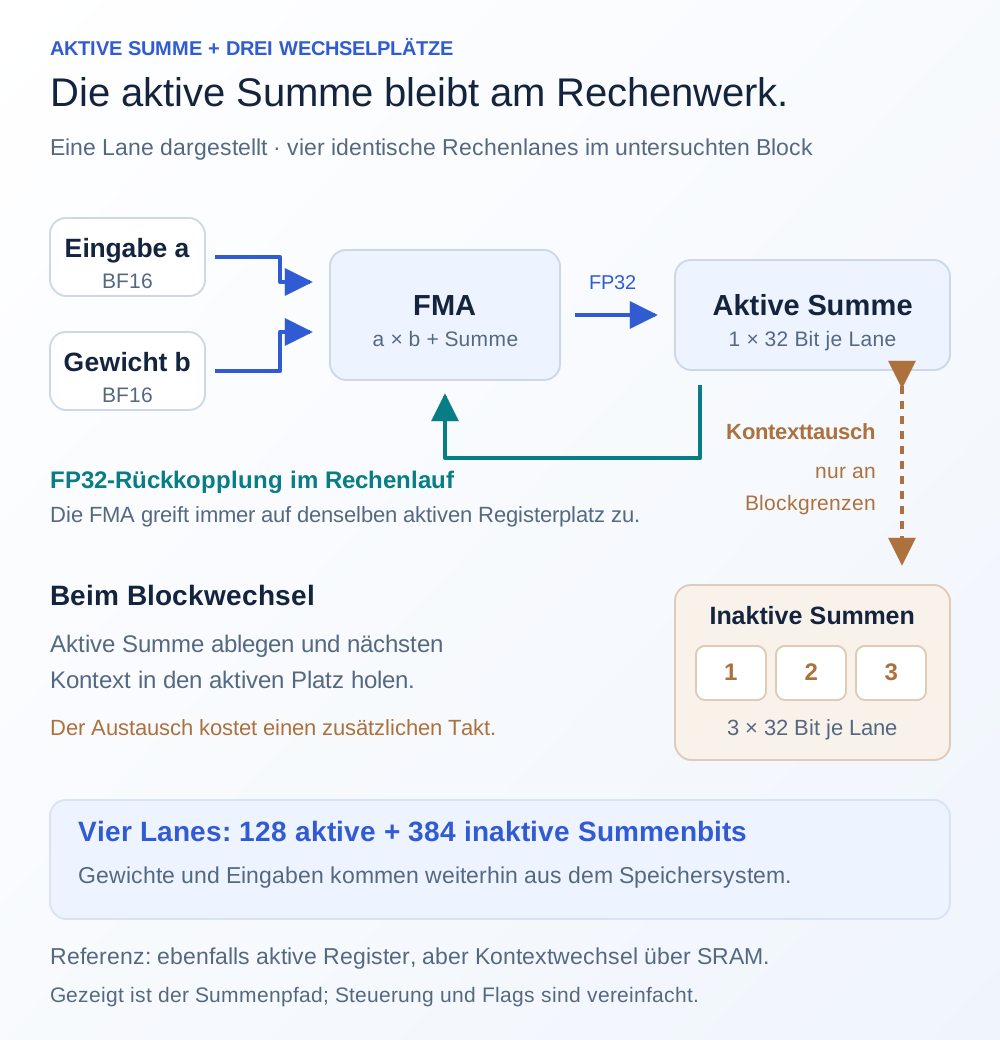
Vier unveränderte HardFloat-Lanes lesen ihre aktive FP32-Summe unmittelbar aus einem festen Register. Drei weitere Plätze halten die inaktiven Summen. Ein geändertes Kontextkennzeichen löst einen Tausch mit dem aktiven Register aus und kostet einen zusätzlichen Takt ohne Rechnung. Insgesamt bleiben 128 aktive und 384 inaktive Summenbits. Die Auswahl verschwindet nicht vollständig, liegt aber nicht mehr vor dem Summeneingang jeder FMA.
Ein eingefrorener Hauptfall und passende Gegenfälle
Der vorab festgelegte Hauptfall verwendet vier Kontexte, K = 128 und Blöcke mit 64 Summenschritten. Die Referenz und der Kandidat bearbeiten dieselben 2.048 Lane-FMAs. Ein einzelner Kontext prüft, ob zusätzliche Register und Steuerung auch dann kosten, wenn kaum Kontextwechsel eingespart werden können. Weitere gepaarte Fälle verändern Blocklänge, K, Rückstau und Sonderwerte. Ein K = 5.120-Fall enthält vier reale Qwen-Gate-Gewichtszeilen.
Zu den sechs unveränderten Vergleichsfällen kommen drei zusätzliche Funktionstests mit unregelmäßigen Kontextfolgen, Zwischenausgaben und Rückstau. Zusammen bestehen 91.788 Lane-FMAs den Vergleich mit einer unabhängigen Ganzzahlreferenz. Ausgabebits und kumulierte Ausnahmeflags stimmen überein. Die drei neuen Fälle wurden nicht nachträglich auf der Referenz ausgeführt und liefern deshalb keine zusätzlichen gepaarten Leistungswerte.
Gleicher physischer Rahmen, neue Datenführung
Alle drei Entwürfe verwenden dieselbe 8-KiB-SRAM mit 64-Bit-1RW-Anschluss, vier Rechenlanes und einen 1.600 × 1.200 µm großen Floorplan. Der Prozess ist IHP SG13G2 am TT-Punkt bei 1,20 V und 25 °C. Der gemeinsame Zieltakt beträgt 50 ns. Die zwei früheren Referenzen bleiben eingefroren. Sie werden nicht erneut geroutet, um einen günstigeren Vergleich zu erzeugen.
Der neue Datenweg besteht detaillierte Verdrahtungsprüfungen ohne gemeldete DRC- oder Antennenverletzungen sowie extrahierte Setup- und Hold-Prüfungen. Unverbundene Taktbaum-Dummy-Ausgänge werden einzeln geprüft und von funktionalen Signalen unterschieden. Externe Operandenquellen liegen außerhalb des Blocks. Hostzugänge sind vorhanden, Hostverkehr ist jedoch nicht Teil der ausgewerteten Aktivitätslast.
Taktzahl und Timing gemeinsam auswerten
| Hauptfall | Ein Kontext | Vier direkt ausgewählt | Aktive Summe |
|---|---|---|---|
| Takte | 572 | 520 | 531 |
| Zeit bei 50 ns | 28,600 µs | 26,000 µs | 26,550 µs |
| STA-Minimalperiode | 17,33 ns | 20,15 ns | 16,68 ns |
| Takte × eigene STA-Grenze | 9,913 µs | 10,478 µs | 8,857 µs |
Gegenüber einem Kontext spart die aktive Summe 41 von 572 Takten. Das entspricht 7,17 % kürzerer Zeit am gleichen Takt. Die zusätzliche Tauschphase erklärt, weshalb sie elf Takte mehr benötigt als die direkte Vierfachauswahl. Gleichzeitig sinkt ihre extrahierte Minimalperiode auf 16,68 ns.
Die Multiplikation von Taktzahl und jeweiliger STA-Grenze ergibt 10,65 % kürzere rechnerische Zeit gegenüber einem Kontext und 15,47 % gegenüber der vorherigen Vierfachauswahl. An diesen Grenzfrequenzen wurde nicht nachgespielt. Die am gemeinsamen 50-ns-Takt ausgeführte Aktivitätsrechnung bleibt davon getrennt.
Die Energiebilanz enthält den Preis der Register
Die modellierte Kachelenergie steigt im Hauptfall von 276,169 auf 281,608 nJ, entsprechend 1,97 %. Die aktive Instanzfläche einschließlich SRAM wächst von 490.120 auf 523.472 µm², also um 6,80 %. Gegenüber dem vorherigen Vier-Kontext-Entwurf sinkt die Energie um 7,11 %. Im Einzelkontext-Gegenfall steigt sie gegenüber der ursprünglichen Referenz um 3,20 %.
Gezählt werden Rechen- und Kontextblock, Taktbaum, SRAM sowie extrahierte Leitungen. Zwei identische Aktivitätsfälle wurden mit bedingten Zell- und Leitungsverzögerungen bitgenau nachgespielt. Neun positive und absichtlich scheiternde Kontrollen qualifizieren den Simulatorpfad. Ein Offlineaudit prüft unter anderem Quellhashes, Transaktionen, Netzbindung, Wellenform und unabhängig aufsummierte Zellleistungen. Es handelt sich um eine modellierte Energie fertiger Arbeit, nicht um eine Siliziummessung.
Numerische Auffälligkeit und belastbare Entwurfsentscheidung
Eine passive Antennenzelle lieferte einen winzigen negativen Modellleistungswert. Die ursprüngliche strenge Prüfung stoppte daran. Die Rohdaten blieben erhalten. Eine nachträglich ergänzte Intervallrechnung behandelt ausschließlich identifizierte passive Beiträge unter eng begrenzten Schwellen. Ihr Hauptfallintervall beträgt 281,608413656 bis 281,608415476 nJ. Diese minimale Spannweite verändert den Befund nicht und ist keine Abschätzung der gesamten Modell- oder Prozessunsicherheit.
Die vorab festgelegte gemeinsame Hürde verlangte mindestens 10 % weniger STA-Grenzzeit und 10 % weniger modellierte Energie. Der Zeitteil wird erreicht, der Energieteil nicht. Erhalten bleibt ein nachweislich schnellerer eigener Kontextbaustein mit beziffertem Flächen- und Energieaufwand. Vollmodellenergie, externe Gewichtsversorgung, Board und Kühlung wurden nicht bilanziert. Der Bericht begründet damit eine konkrete lokale Architekturentscheidung und benennt genau, welche weitergehenden Aussagen der Vergleich noch nicht trägt.
Die drei Kacheln im direkten Vergleich
| Größe | Referenz Ein aktiver Kontext | Zwischenstand Vier direkt ausgewählte Kontexte | Neuer Entwurf Aktive Summe + Wechselplätze |
|---|---|---|---|
| Takte | 572 | 520 | 531 |
| Zeit bei 50 ns | 28,6 µs | 26 µs | 26,55 µs |
| STA-Minimalperiode | 17,33 ns | 20,15 ns | 16,68 ns |
| Zeit an eigener STA-Grenze | 9,91276 µs | 10,478 µs | 8,85708 µs |
| Modellierte Kachelenergie bei 50 ns | 276,169383 nJ | 303,154514 nJ | 281,608415 nJ |
| Aktive Instanzfläche | 0,49012 mm² | 0,533624 mm² | 0,523472 mm² |
Konsequenz für den nächsten Entwurf
Den schnelleren Kontextbaustein und den vollständig dokumentierten Layoutvergleich in die Forschungsbasis übernehmen. Das Ergebnis zeigt einen konkreten Architekturgewinn mit einem bezifferten Energie- und Flächenaufwand.