Architektur

Kurze Wege.
Veränderbare Modelle.

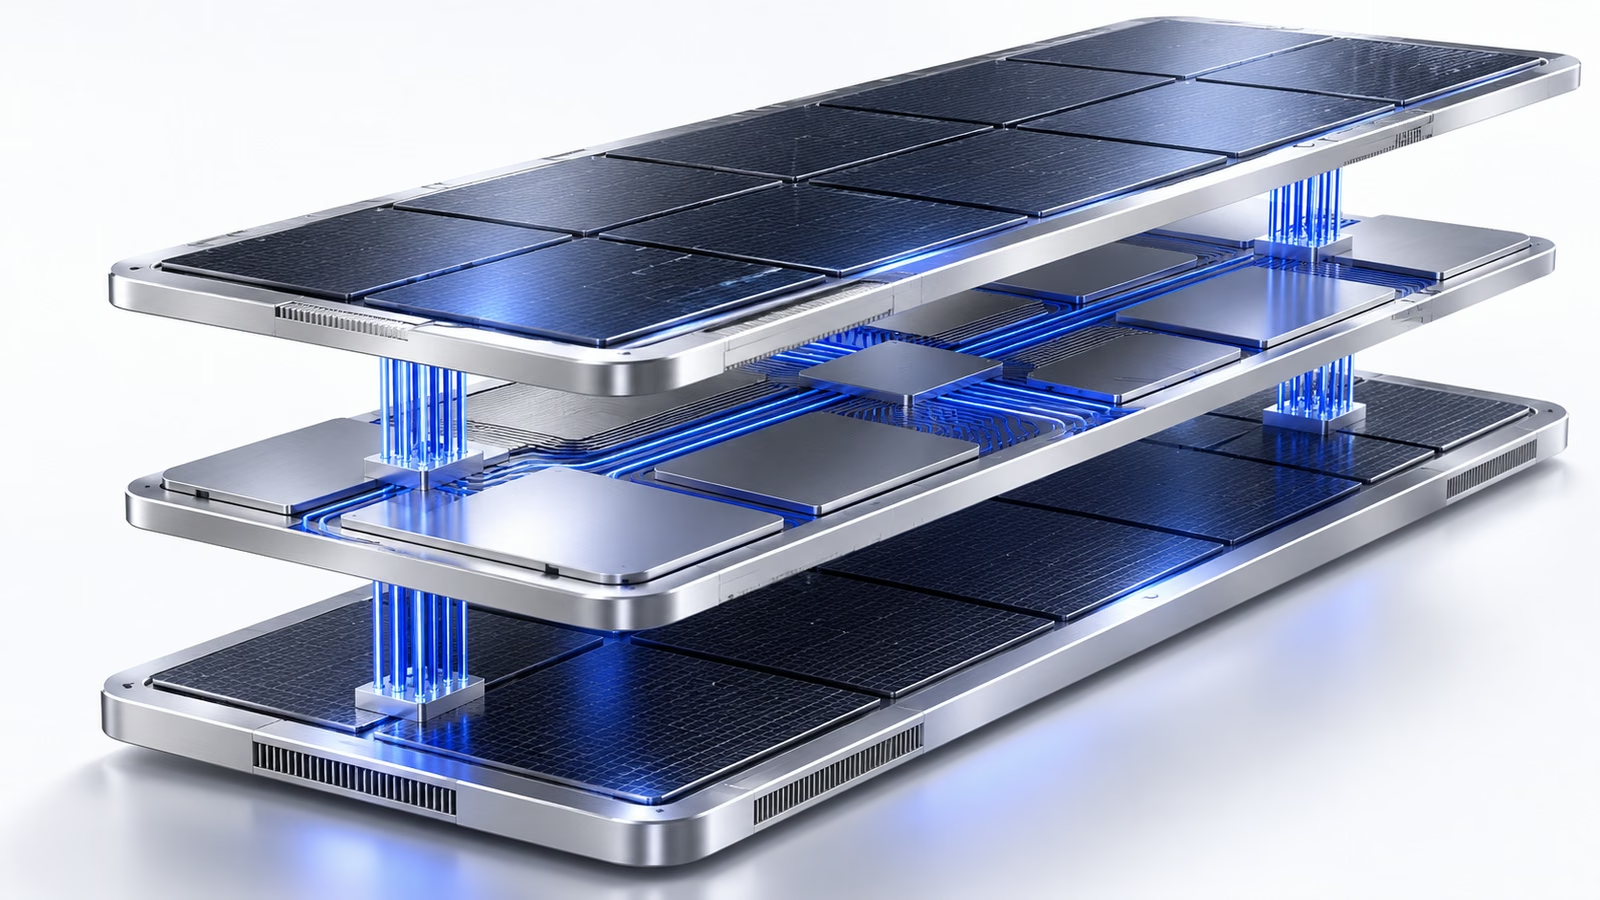
Wir richten Rechenwerke, Speicher und Verbindungen an den Datenwegen des Modells aus. Gewichte und Programme bleiben veränderbar.

Schichtweise angeordnete Rechenmodule mit kurzen Verbindungen

Das Systembild

Rechnen, wo die Daten sind.

Modulares Systembild mit lokalen Gewichten und weitergereichten ZwischenergebnissenLaufzeitsoftware verteilt Programme und Gewichte. Zwei verbundene Rechenmodule besitzen jeweils Speicher, ein Rechenwerk und lokale Summen. Ein Rückkanal führt Ergebnisse zur Software. Die Grafik ist ein Konzept, kein fertiges Chip-Layout.Runtime / HALAufträge · GewichteErgebnisrückgabeRechenmodul ARechenmodul BLokale, veränderbare GewichteFMA · aktive SummePuffer · SpeicherportsLokale, veränderbare GewichteFMA · aktive SummePuffer · Speicherports
Konzeptbild. Kleine Operator- und Verbindungspfade sind geprüft. Der vollständige große Systemaufbau ist offen.

Die aktive Summe im Mittelpunkt

Gewichte wiederverwenden, Zwischenwerte direkt weiterreichen und fortlaufende FP32-Summen nahe am Rechenwerk halten: Diese drei Beiträge untersuchen wir in getrennten Versuchen und verbinden sie über klar definierte Schnittstellen.

Speicher bleibt eine physische Ressource

Kapazität allein genügt nicht. Speicherbänke, gleichzeitig nutzbare Ports, Rückstau, Antwortpuffer und die aktive Schicht bestimmen, wie viel Bandbreite wirklich ankommt. Register sparen SRAM-Verkehr, benötigen aber Fläche, Taktenergie und Auswahlleitungen.

Prefill und Decode verlangen verschiedene Pläne

Viele Eingabetokens können beim Prefill dieselben Gewichte gemeinsam nutzen. Einzelne Decode-Tokens sind in unserer bisherigen Abbildung stärker durch die äußere Gewichtsbereitstellung begrenzt. Ein optimaler Tokenblock für einen Fall ist deshalb kein universeller Gewinner.

Größe ist eine Entwurfsvariable

Mehrere Dies, größere Träger und modulare Rechen-Speicheranordnungen bleiben im Suchraum. Wir bewerten die gesamte Datenbewegung, Versorgung, Kühlung und aktive Bandbreite. Die Summe vieler Speichermodule wird nicht automatisch zur Bandbreite der gerade benötigten Modellschicht.

Ein Modellwechsel ohne neuen Maskensatz

Die Architektur soll aktualisierte Gewichte, Zustände und Programme innerhalb erklärter Kapazitäts- und Operationsgrenzen ausführen. Größere Modelle können zusätzliche kompatible Module benötigen. Fest in Masken eingebrannte Modellgewichte erfüllen dieses Ziel nicht.
Der aktive Kontext

Ein fester Rechenpfad.
Drei Wechselplätze.

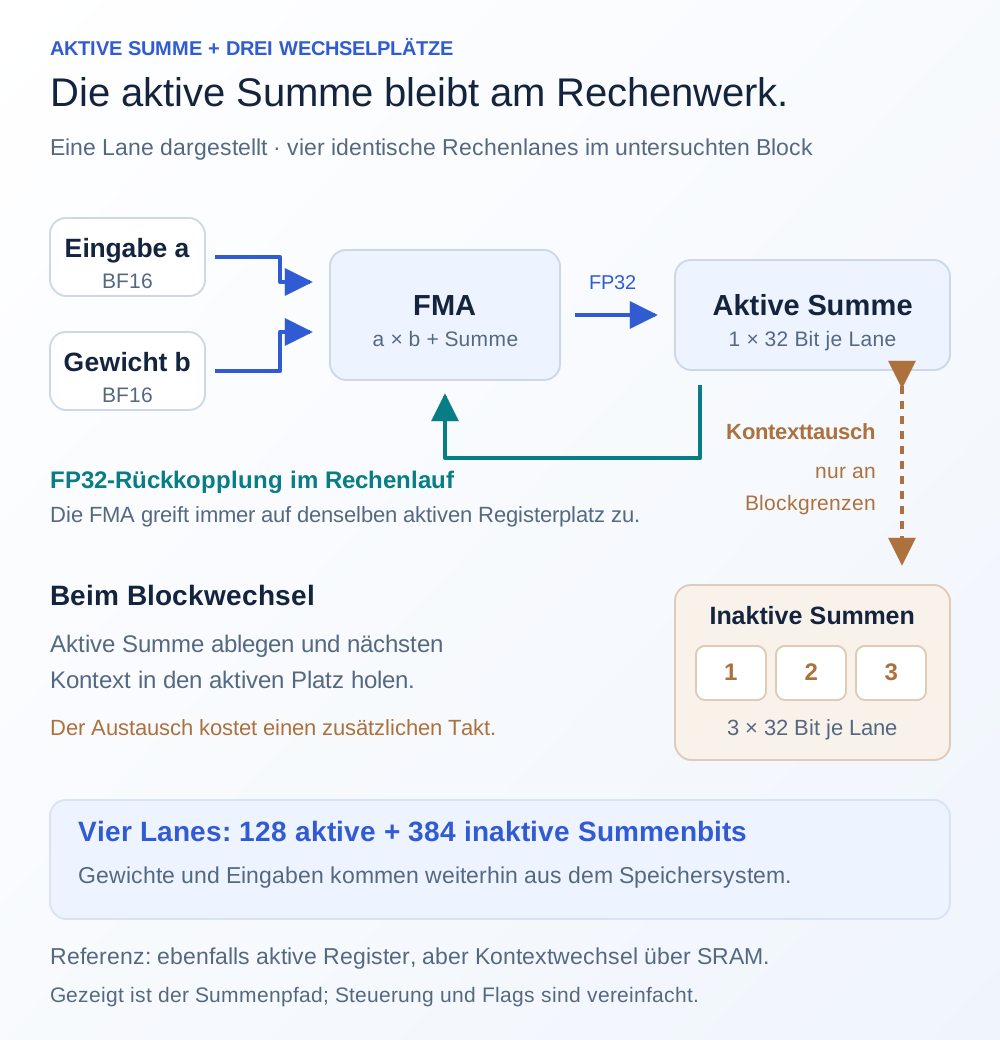
Die Grafik zeigt eine der vier Rechenlanes: Die aktive FP32-Summe bleibt direkt mit dem FMA-Rechenwerk verbunden. Drei weitere Summenkontexte wechseln ausschließlich an Blockgrenzen in den aktiven Platz. Gewichte und Eingaben kommen weiterhin aus dem Speichersystem.

Eine von vier Lanes: BF16-Eingabe a und BF16-Gewicht b gehen in die FMA. Ihr FP32-Ergebnis wird im aktiven Register gespeichert und auf den Summeneingang zurückgeführt. Drei weitere FP32-Summen liegen in lokalen Registern. Nur an Blockgrenzen tauscht die Steuerung den aktiven und einen inaktiven Kontext; der Austausch kostet einen zusätzlichen Takt. Die vier Lanes enthalten zusammen 128 aktive und 384 inaktive Summenbits. Auch die Referenz besitzt aktive Register, nutzt jedoch SRAM für Kontextwechsel. Operandenspeicher bleiben nötig.

Vom Baustein zum System

Jede Ebene gehört
in die Bilanz.

Ein kurzer Datenweg im Rechenwerk ist ein konkreter Anfang. Packaging, Verbindungen, Versorgung und Kühlung bestimmen, was daraus auf Systemebene wird.

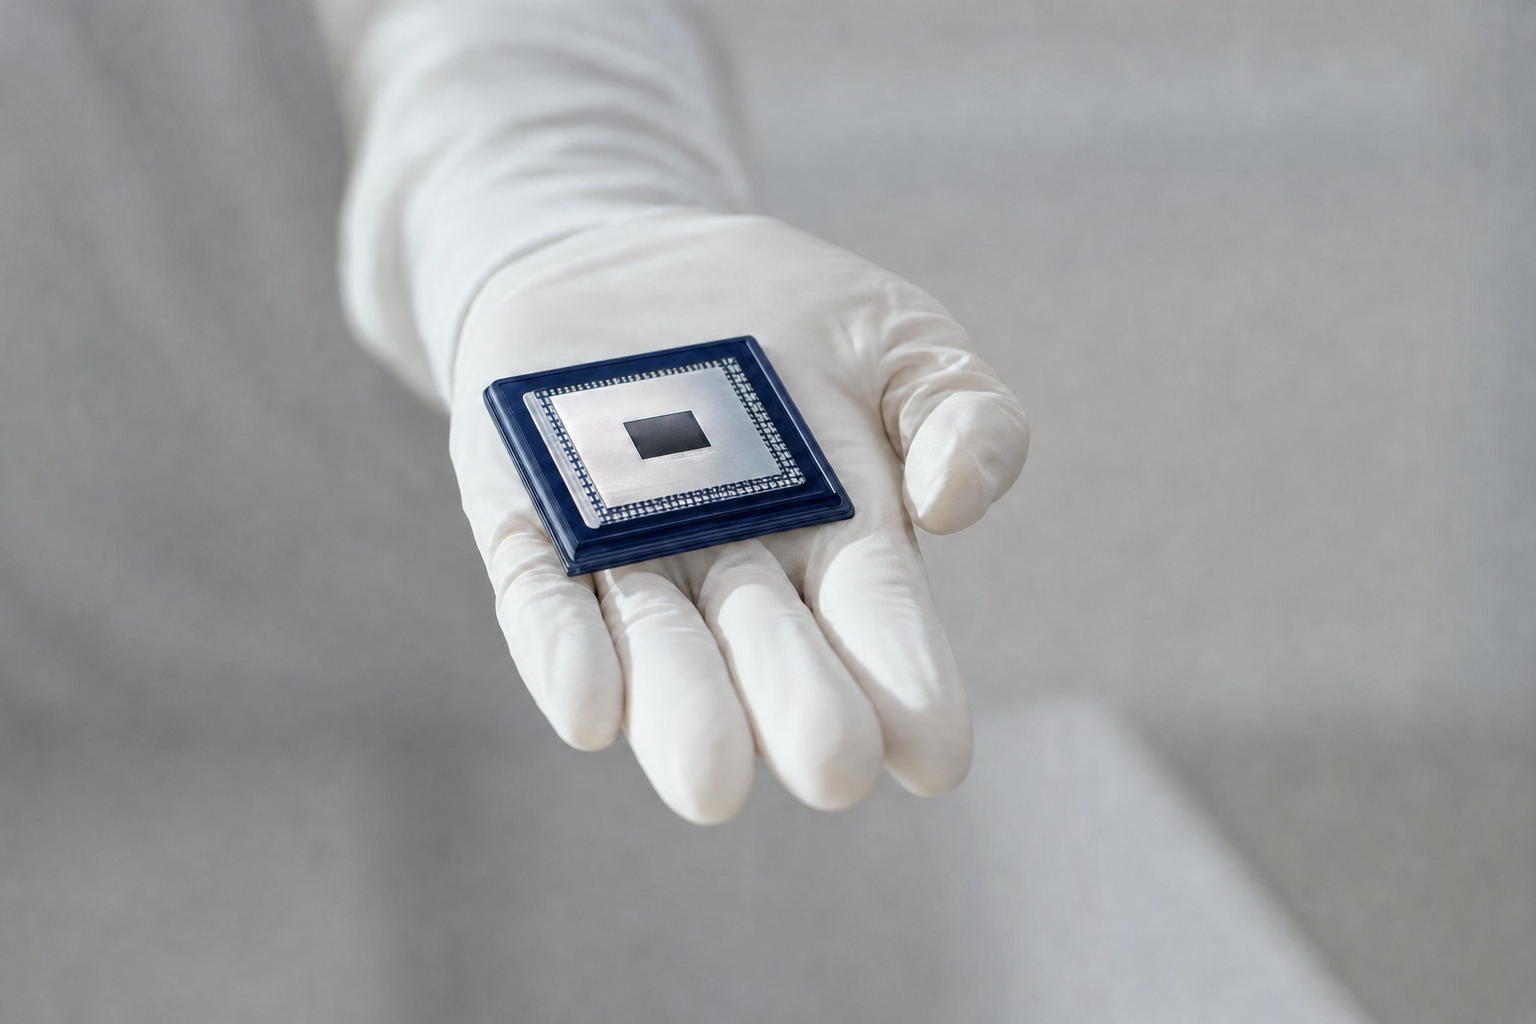
Offenes Chippackage auf behandschuhter Hand

Chip und Gehäuse

Die Rechenkachel muss mit realen Anschlüssen, Versorgung und einem geeigneten Träger zusammenspielen. Unser Layoutvergleich untersucht zunächst den kleinen Rechen- und Kontextblock.

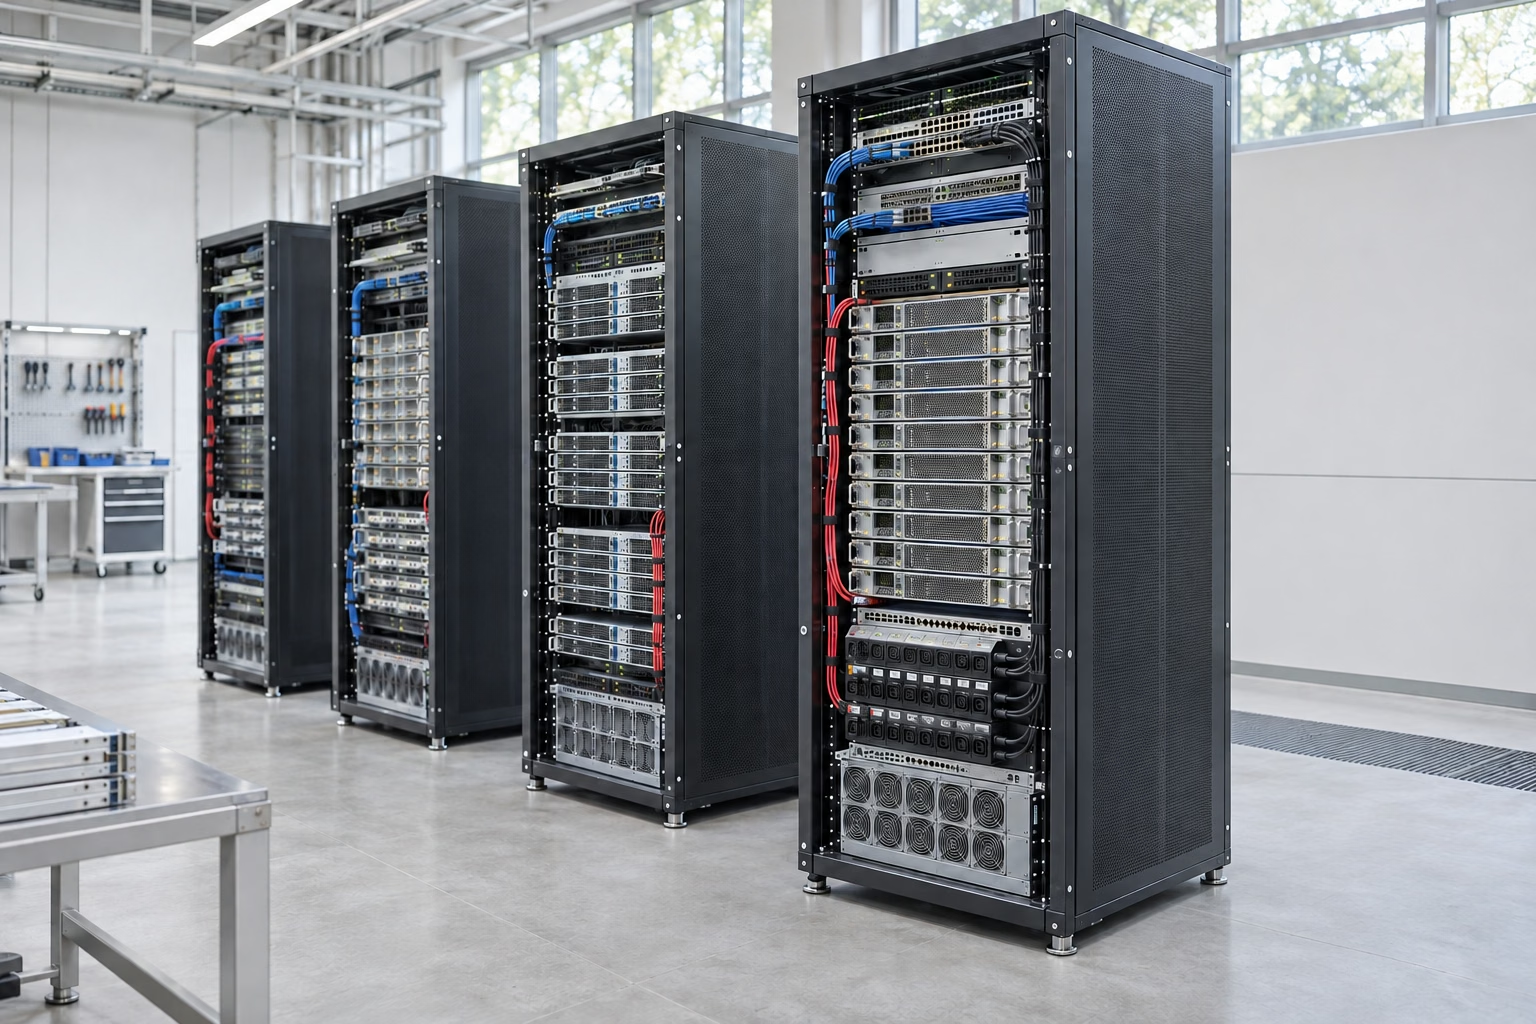
Vier Serverracks mit geordneten Kabelwegen in heller technischer Umgebung

Module und Serversystem

Mit der Systemgröße wachsen auch die Anforderungen an Datenwege und Versorgung. Ein Vollmodellvergleich muss diese gesamte Grenze auf beiden Seiten berücksichtigen.