Forschungsbericht · überarbeitet am 09. November 2026
Drei Projektionen mit einem gemeinsamen Zahlenvertrag
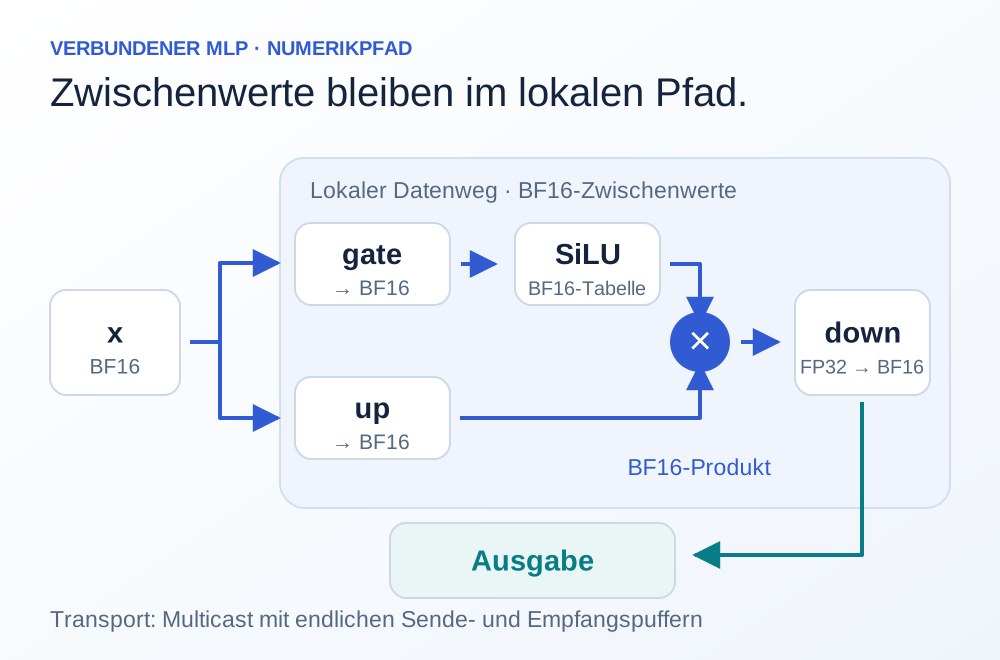
Der untersuchte Teilgraph besitzt D = 5.120 Eingaben, H = 17.408 Zwischenwerte und O = 5.120 Ausgaben. Gate und up berechnen zwei Projektionen derselben Eingabe. Anschließend entsteht der Zwischenvektor aus SiLU(gate) × up. Down projiziert ihn zurück in die Ausgabedimension. Diese Topologie entspricht dem archivierten Modellinventar.
Beide Datenwege verwenden BF16-Eingaben und -Gewichte sowie fortlaufende FP32-FMA in aufsteigender K-Reihenfolge. Gate und up werden auf BF16 gerundet. SiLU verwendet eine festgelegte gemeinsame Tabelle, danach folgt ein BF16-Produkt. Down akkumuliert wieder in FP32 und rundet abschließend auf BF16. Die Tabelle definiert den Vergleichsvertrag, aber keine universelle Bitgleichheit zu jedem GPU-Backend. Ihre 87 zusätzlich mit hoher Dezimalpräzision geprüften Werte ersetzen keinen erschöpfenden Nachweis aller transzendenten Rundungsgrenzen.
Funktion prüfen, bevor Datenwege bewertet werden
Dreizehn deterministische Fälle prüfen verschiedene Formen, Tokenzahlen, ungleiche Modulaufteilungen und Restpakete. Ein Fall verwendet sechs echte archivierte Gate-Gewichtszeilen mit K = 5.120. Eingaben sowie up und down bleiben dort synthetisch. Eine unabhängige Python-Integer-FMA erzeugt Erwartungswerte. C++ std::fma berechnet sowohl den zentral abgelegten Zwischenvektor als auch den Streamingpfad. Alle 3.621 geprüften FP32- und BF16-Werte stimmen überein.
Der Vertrag verteilt Ausgabezeilen der Down-Projektion. Jedes Modul behält die vollständige geordnete Summe seiner Ausgaben. Eine alternative Verteilung über K würde lokale Teilsummen erzeugen. Sie liefert bereits 38 andere FP32-Ausgaben in den Testfällen. Ein gerichteter Fall mit den Produkten 2²⁴, 1 und −2²⁴ zeigt außerdem ein anderes BF16-Ergebnis. Deshalb wird eine solche Umordnung hier nicht als kostenlose Parallelisierung zugelassen.
Die zentrale Referenz darf bereits überlappen
Beide Varianten besitzen dieselben 160 Module, Gewichtsquellen und lokalen SiLU-Produkt-Stufen. Die Referenz schreibt Zwischenpakete in einen begrenzten zentralen Ring und verteilt sie von dort an down. Sie darf Schreiben, Lesen und Rechnen überlappen. Der Kandidat überträgt direkt per Multicast. Reservierte Quell- und Empfangsplätze bleiben bis zur tatsächlichen Übergabe belegt.
Der zentrale Ring fasst acht Pakete, je Quelle und Empfänger sind zwei Plätze vorgesehen. Ein Paket enthält 16 Features über den Tokenblock. Bei M = 256 vermeidet die direkte Variante 17.825.792 Byte zentrale SRAM-Zugriffe und 8.912.896 Byte zusätzliche Netzeinspeisung je MLP. Empfangskopien und Multicast-Baumkanten bleiben erforderlich. Die äußere Gewichtsmenge ist in beiden Fällen 534.773.760 Byte. Entfallene zentrale Zugriffe sind somit nur ein Teil der gesamten Datenbewegung.
Die Rangfolge hängt von Verbindung und Ports ab
SimPy 4.1.2 bildet konkurrierende Dienste, endliche Puffer und Rückstau ab. Der Gate/up-Anteil verwendet eine optimistische Ressourcenhülle, die Down-Gewichtszufuhr einen idealen begrenzten Dienst. Es wurde in dieser Runde kein neuer Ramulator-Lauf ausgeführt. DRAM-Kommandokonflikte und Refreshverluste werden deshalb nicht vollständig neu bestimmt. Alle 17 vorher festgelegten Variantenpaare sind ausgeführt und archiviert.
| Tokens / Link | Zentral | Direkt | Direkter Effekt |
|---|---|---|---|
| M1 / 6,4 GB/s | 112,376 µs | 112,369 µs | 0,006 % kürzer |
| M32 / 6,4 GB/s | 542,091 µs | 385,369 µs | 28,91 % kürzer |
| M256 / 6,4 GB/s | 4.198,619 µs | 2.945,059 µs | 29,86 % kürzer |
| M256 / 64 GB/s | 790,821 µs | 790,547 µs | 0,035 % kürzer |
| M256 / 256 GB/s | 586,275 µs | 655,475 µs | 11,80 % länger |
Der zentrale Ring kann Arbeitsphasen entkoppeln und Pakete früher bereitstellen. Zwei nachträgliche Portkontrollen zeigen, dass breitere lokale Ports die Zeitumkehr verändern. Sie sind ausdrücklich explorative Ursachenprüfungen und keine zusätzlichen vorab festgelegten Vergleichsfälle.
Lokale Zustände sind der nächste physische Engpass
Die direkte M256-Variante benötigt 69,9375 MiB Payloadspeicher, die zentrale Referenz 70 MiB. Der Kapazitätsgewinn beträgt lediglich 64 KiB, weil der zentrale Ring bereits klein ist. Enthalten sind unter anderem 34 MiB Gate/up-Summen, 5 MiB Down-Summen und insgesamt 20 MiB replizierte SiLU-Tabellen. Controller, ECC und Banking kommen hinzu.
Die schnelle Arrayannahme verlangt 8.192 Byte Akkumulatorzugriffe je Modul und angenommenem 1-GHz-Zyklus. Eine naive Umsetzung mit je einem vorhandenen 8-KiB-IHP-Makro pro 64-Bit-1RW-Port würde allein rund 43.245 mm² Makrofläche benötigen. Das ist keine allgemeine Untergrenze für Register oder andere Prozesse. Es zeigt, dass eine kleine gespeicherte Datenmenge noch keine realisierbare Portzahl garantiert. Bei nur 512 Byte Akkumulatorzugriff steigt derselbe direkte M256-Modellfall auf etwa 6.882 µs statt rund 791 µs.
Was der verbundene Teilgraph für das Systemziel leistet
Die lokale Weitergabe ist funktional bestätigt und kann bei schmaler Verbindung erhebliche Modellzeit sparen. Sie liefert aber keinen allgemeinen Sieger. In einer ergänzenden seriellen BF16-Abbildung bewegen die übrigen Prefill-Projektionen ohne MLP noch 48.662.821.888 Byte. Bei 6,4 GB/s benötigen allein diese Transfers mindestens 7,604 Sekunden. Selbst ein kostenloser MLP könnte diesen konkreten Aufbau nicht unter das historische 5,429-Sekunden-Ziel bringen.
Gesamtenergie bleibt nicht bestimmt. Die entfallenden zentralen Zugriffe stehen weiteren Kopien, Ports, Tabellen und Steuerung gegenüber. Der Versuch begründet deshalb die nächste engere Frage nach lokalen FP32-Registern und Gewichtsblock-Wiederverwendung. Er hält den funktionierenden Teilgraphen fest, ohne aus einer bedingten Teilzeit eine vollständige Qwen-Laufzeit oder einen Siliziumvorteil abzuleiten.
Konsequenz für den nächsten Entwurf
Den verbundenen Teilgraphen und die Vergleichsfälle für lokale Datenversorgung weiterverwenden.