Forschungsbericht · überarbeitet am 09. November 2026
Vom unabhängigen Kanal zum rückgekoppelten Ablauf
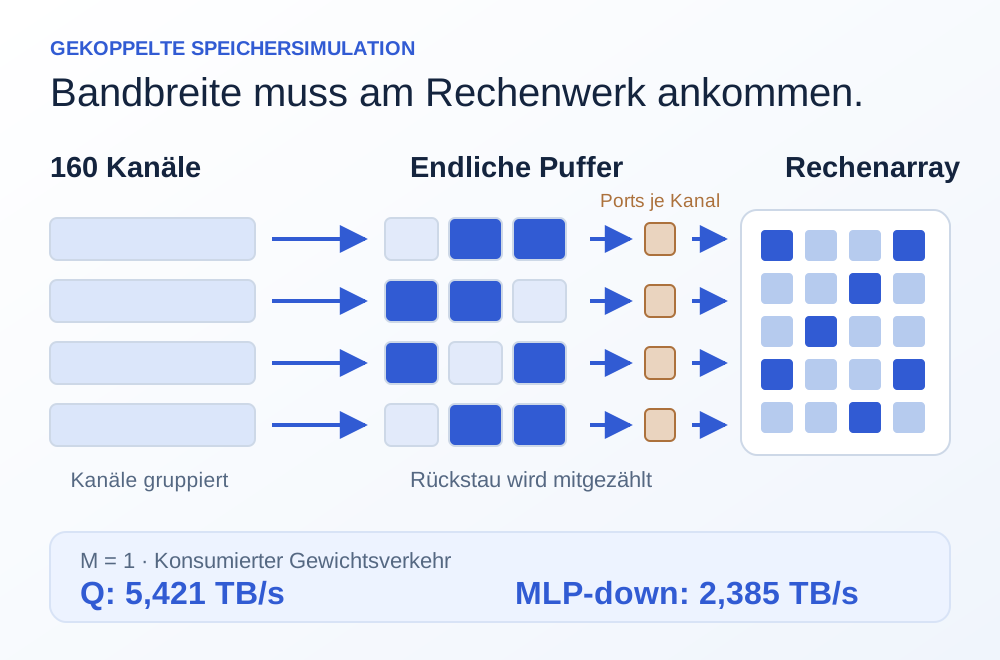
Das C++-Frontend ConnectedArray ist mit einem festgelegten Ramulator-2-Quellstand kompiliert. DRAM-Timings, Controller, Scheduler und integrierte Ayna-Energieimplementierung bleiben unverändert. Ein Gewichtsrequest darf nur gestellt werden, wenn vorher ein Antwortplatz reserviert wurde. Dieser Platz wird erst nach Verarbeitung freigegeben. Speicherantworten, Rechenfortschritt und Rückstau beeinflussen sich somit während desselben Laufs.
Der große Fall enthält 160 simulierte Kanäle. Jeder besitzt einen eigenen Controller und Gewichtsdienst. Eine gemessene Einzelkanalzahl wird nicht einfach mit 160 multipliziert. Alle 23 vorher festgelegten Fälle liegen vollständig vor. Zwei wiederholte Kontrollen reproduzieren native Zeiten, Bandbreiten und Speicherenergie. Fehlgeschlagene Exportversuche bleiben von erfolgreich gesicherten einzelnen Ergebnissen getrennt dokumentiert.
Welche Hardware der Simulator voraussetzt
Verwendet wird das Profil HBM4_32Gb_8Hi mit HBM4_8000Mbps, nominal 64 GB/s je Kanal. 160 Kanäle entsprechen fünf modellierten Stapeln mit zusammen 160 GiB Kapazität und 10,24 TB/s nomineller Bandbreite. Der Controller nutzt FRFCFSRowHit, offene Zeilen, All-Bank-Refresh und 128 Read-Queue-Einträge. Davon getrennt werden 8, 128 oder 512 reservierbare Antwortplätze zu je 32 Byte getestet.
Die Rechengeometrie umfasst je Kanal zwei Engines, 16 Ausgabelanes und 32 Tokenlanes. Das ergibt 163.840 angenommene MAC-Einheiten bei hypothetischen 1 GHz und vier Takten FP32-Rückkopplung. Die vorhandene kleine RTL-Kachel beweist weder diese Größe noch diese Frequenz. Untersucht werden vollständige Q-Formen mit N = 12.288 und K = 5.120 sowie MLP-down mit N = 5.120 und K = 17.408. K256-Schnitte sind gesondert ausgewiesen.
Decode zeigt unterschiedliche Grenzen derselben Kanäle
| M = 1 | Konsumierte Gewichte | Kernelzeit |
|---|---|---|
| Q, 160 Kanäle, 8 Plätze | 2,132 TB/s | 59,803 µs |
| Q, 160 Kanäle, 128 Plätze | 5,421 TB/s | 23,989 µs |
| Q, 160 Kanäle, 512 Plätze | 5,822 TB/s | 22,390 µs |
| MLP-down, 160 Kanäle, 128 Plätze | 2,385 TB/s | 75,076 µs |
Mehr Antwortplätze verkürzen Q um 6,67 % und erhöhen seinen Durchsatz um 7,14 %. Der Payloadpuffer wächst dabei von 0,625 auf 2,5 MiB. MLP-down nutzt trotz derselben Kanäle deutlich weniger Bandbreite. Seine lange geordnete Summation liegt nahe der Abhängigkeitszeit von rund 69,6 µs. Mehr ankommende Gewichte können diese Kette nicht beliebig verkürzen.
Für M = 1 bleiben außerdem 31 der 32 Tokenpositionen ungenutzt. Die feste Arrayform passt damit anders zu Decode als zu Prefill. Eine umschaltbare Geometrie wäre ein neuer Entwurf und wird hier nicht kostenlos vorausgesetzt.
Prefill braucht Wiederverwendung und genügend Eingabefenster
Im K256-Prefill-Schnitt mit M = 256 benötigen 128 Antwortplätze und vier Eingabeabschnitte 54,329 µs bei angenommenen 256 GB/s Aktivierungslink. 512 Plätze reduzieren diese Zeit nur auf 54,319 µs. 32 Eingabeabschnitte sind nicht schneller als vier. Ein einzelner Abschnitt verlängert die Zeit auf 58,402 µs. Zusätzliche Puffer helfen folglich nur, solange sie einen tatsächlichen Engpass beseitigen.
Der vollständige Q-Prefill mit K = 5.120 und M = 256 liefert während der nativen Rechnung 156,645 TMAC/s und benötigt einschließlich analytisch ergänzter Ausgabe 151,981 µs. Sein konsumierter Gewichtsverkehr beträgt 1,224 TB/s. Die niedrigere Bandbreite gegenüber Decode ist hier erwartbar, weil ein Gewicht für 256 Tokens verwendet wird. Das Ergebnis bezeichnet einen Operatorblock, nicht den gesamten Prefill mit 8.192 Tokens.
Eine Untergrenze kann einen Aufbau früh ausschließen
Die ergänzende Bilanz verwendet alle 16 gruppierten Projektionsformen des archivierten Inventars, 8.192 Prefill-Tokens, einen letzten lm_head-Schritt und 255 weitere Decode-Schritte. In der untersuchten Abbildung lädt jede nicht zusammengefasste Operation ihren Input und schreibt FP32-Ausgaben über denselben zentralen Pfad. Allein im Prefill entstehen 183.493.414.912 Byte Aktivierungsverkehr.
Bei 6,4 GB/s benötigen diese Transfers mindestens 28,671 Sekunden. Selbst der optimistische Fall mit 256 GB/s und M256-Blöcken ergibt für sämtliche Projektionen 5,368 Sekunden. Für das historische 5,429-Sekunden-Ziel mit 10 % Reserve dürften sie höchstens 4,886 Sekunden benötigen. Andere Modelloperatoren sind in dieser günstigen Untergrenze noch nicht enthalten. Damit wird diese konkrete zentrale Abbildung ausgeschieden, ohne einen großen Layoutlauf zu benötigen.
Kapazität, lokale Ports und Energie bleiben eigene Größen
Die größte Projektion benötigt mindestens 20,4375 MiB gezählten Payloadspeicher. Dazu kommen Tags, Controller, ECC und weitere Zustände. Bei voller angenommener Auslastung entstehen logisch bis zu 1,31072 PB/s verteilte FP32-Akkumulatorzugriffe. Dies ist lokaler Verkehr, keine zusätzliche HBM-Forderung. Register, Banking und Weiterleitung müssen seine physischen Ports und seinen Fanout erst realisieren.
Ayna liefert beispielsweise 5,157 mJ Speicherenergie für Q-Decode mit 128 Plätzen. Rechenlogik, lokale Speicher, Host-PHY, Versorgung und die Warteenergie des analytischen Ausgabeabschnitts fehlen. Gesamtenergie und vollständige Modelllaufzeit bleiben deshalb unbestimmt. Der Simulator erzeugt auch keine vollständigen BF16-Qwen-Ausgaben. Sein Ergebnis ist eine belastbare Ressourcen- und Engpassprüfung, aus der der anschließende verbundene MLP-Versuch mit lokalen Zwischenwerten hervorgeht.
Konsequenz für den nächsten Entwurf
Diese konkrete zentrale Abbildung nicht als großen Chip weiter auslegen.