Forschungsbericht · überarbeitet am 09. November 2026
Ein kleiner Graph mit vollständig erklärter Funktion
Der Vertrag tile-graph-v1 unterstützt zwei Linear-Operationen mit expliziter FP32-Rechnung, einem ReLU zwischen den Operationen und anschließender BF16-Rundung. Batchgröße ist 1, die Eingabetiefe liegt zwischen 1 und 64. Zwischenbreite und Ausgabebreite betragen jeweils vier. Die Gewichte stammen aus realen Qwen-Ausschnitten. Die Zusammensetzung ist jedoch ein synthetischer Graph und bildet keine zwei benachbarten Qwen-Schichten nach.
Der gesamte Pfad umfasst PyTorch-Export, HAL-Übersetzung, residente Gewichtsbeladung, Aktivierungsschreiben, Start des Hardwaregraphen und tatsächliches Ergebnislesen. Nicht unterstützte Graphen scheitern ausdrücklich. Ein erfolgreicher Softwareaufruf kann daher nicht durch eine unbemerkte Ausführung auf der CPU zustande kommen.
Was die Direktverbindung verändert
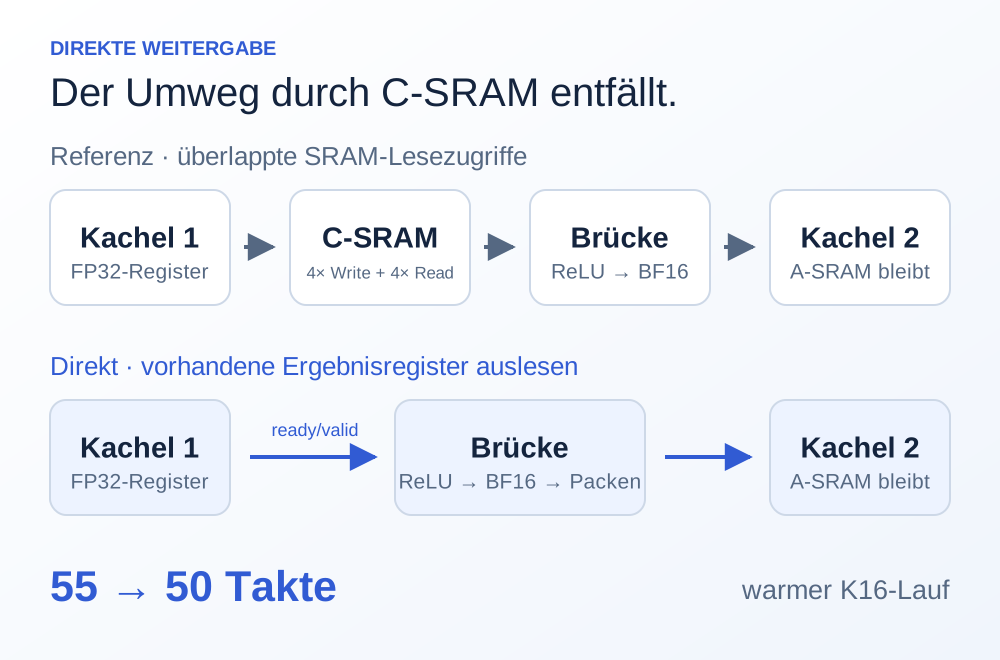
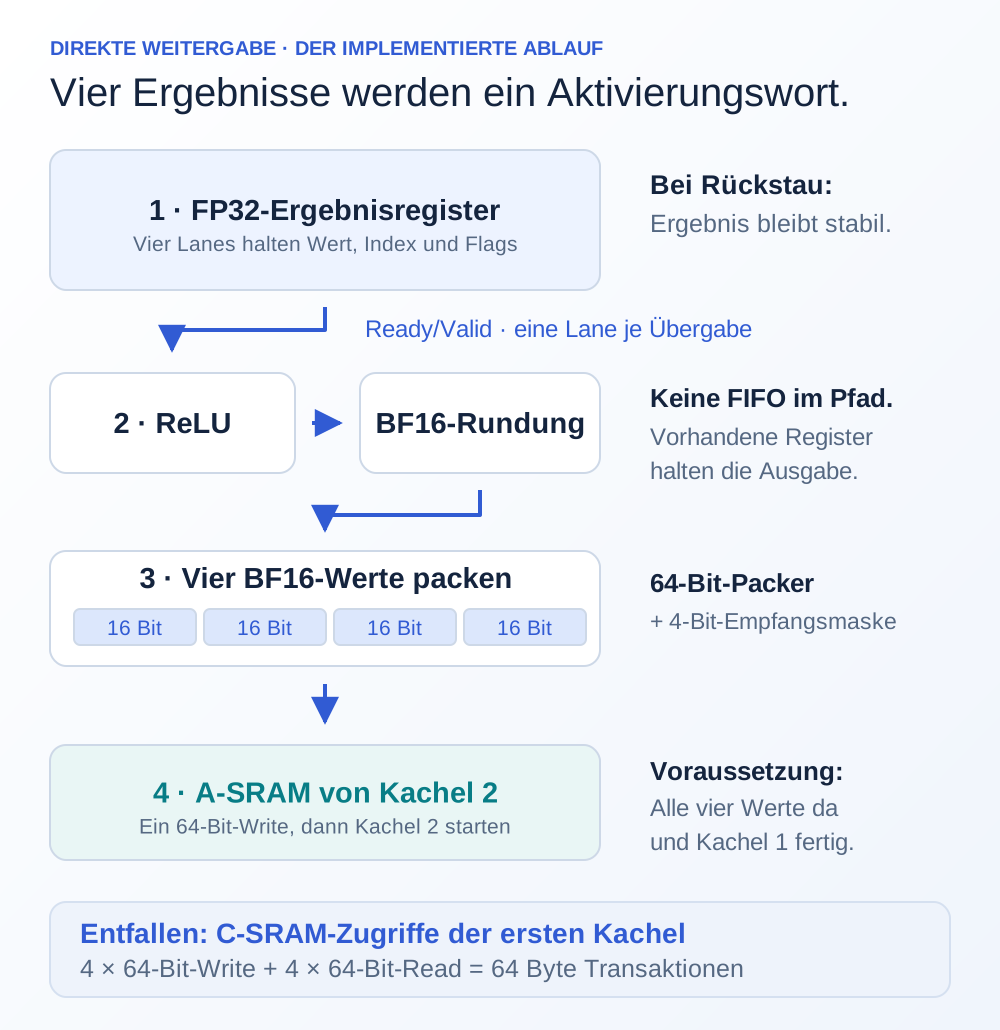
Die Referenz liest Ergebnisse bereits über eine gepipelinte C-SRAM-Brücke. Sie ist damit stärker als ein künstlich vollständig serieller Speicherpfad. Der Kandidat führt die registrierten FP32-Ergebnisse direkt über eine Ready/Valid-Schnittstelle zum ReLU- und BF16-Packer. Bei Rückstau bleiben Ergebnisindex, Wert und Flags stabil, bis der Empfänger die Übertragung annimmt.
Pro Anfrage entfallen vier 64-Bit-C-Schreibzugriffe und vier entsprechende Lesezugriffe. Das sind 64 Transaktionsbytes. Vier direkte Übertragungsschritte und die Packerregister bleiben erforderlich. Auch die zweite Kachel erhält weiterhin ein gepacktes A-SRAM-Wort, das sie später liest. Die Änderung beseitigt folglich einen konkreten Speicherumweg, nicht jede Zwischenablage oder jede Datenbewegung des Graphen.
Gewichtsresidenz und unabhängige Funktionskontrolle
Beide Datenwege besitzen dieselbe Arithmetik, je zwei Kacheln mit acht Speicherbänken sowie dieselbe Ausgabegrenze. Für jede Eingabetiefe werden zwei unterschiedliche Gewichtssätze jeweils für drei Anfragen ohne Kachelreset verwendet. Die 30 Anfragen benötigen gemeinsam 352 kalte 64-Bit-Gewichtsschreibzugriffe statt 1.056 bei ständigem Neuladen. Diese Wiederverwendung gilt für beide Varianten und wird nicht als Vorteil der Direktverbindung angerechnet.
Vier Konfigurationen mit zwei Datenwegen und jeweils mit beziehungsweise ohne Rückstau ergeben 120 Graphausführungen und 480 Prüfungen finaler Werte und Flags. Gerichtete Gegenfälle umfassen Rundungsgleichstände, Auslöschung, subnormale Werte, vorzeichenbehaftete Null und negative Werte. Sieben nicht unterstützte Eingaben werden abgewiesen. Eine unabhängige Ganzzahl-FMA prüft die Ausgaben. Native PyTorch-Ausführungen bestätigen die BF16-Zwischenwerte und die vereinbarte finale FP32-Toleranz.
Fünf Takte bleiben fünf Takte
| Eingabetiefe | SRAM-Brücke | Direkt | Weniger Takte |
|---|---|---|---|
| K = 1 | 34 | 29 | 14,71 % |
| K = 16 | 55 | 50 | 9,09 % |
| K = 64 | 127 | 122 | 3,94 % |
Die warme Anfrage beginnt mit dem ersten Aktivierungsschreiben und endet mit dem letzten Ergebnislesen. Modellbeladung ist separat erfasst. Der absolute Vorteil beträgt in diesen Fällen fünf Takte. Je mehr Rechenarbeit die Anfrage enthält, desto kleiner wird ihr relativer Anteil. Die Rückstaufälle dienen dem korrekten Protokollverhalten. Wegen unterschiedlicher absoluter Phasen der eingebrachten Pausen werden ihre Zeiten nicht als zusätzliche Geschwindigkeitsrangfolge verwendet.
Eine Übertragung auf das ganze Modell hängt vom tatsächlichen Zeitanteil dieses Pfades ab. Belegte er beispielsweise ein Viertel einer Anfrage, ergäben 9,09 % lokale Zeitersparnis nur etwa 2,27 % weniger Gesamtzeit. Dieser Anteil ist eine Sensitivitätsannahme und keine gemessene Qwen-Aufteilung.
Was die physische Näherung ergänzt
Ein ausgeführter OpenROAD-Vorvergleich verwendet gespeicherte Platzierungsdaten und Grobverdrahtungsführungen. Daraus werden Leitungsparasitiken geschätzt und Setup sowie Hold geprüft. Bei einer angenommenen Periode von 25 ns beträgt die Setupreserve 1,376 ns für die Referenz und 2,743 ns für die direkte Variante. Beide bestehen diesen Näherungsvergleich. Die Standardzellfläche ist 0,272 % kleiner, die geschätzte Leitungslänge 2,824 % kürzer.
Ein zusätzlicher Test verdoppelt Leitungswiderstände und Kapazitäten. Er ist ein künstlicher Belastungsfall und kein kalibriertes Prozessintervall. Die vollständigen Schlussdaten eines früheren Detailrouting-Laufs gingen beim Export verloren, zudem blieben Antennenverletzungen. Dieser Lauf liefert deshalb keinen abgeschlossenen physischen Nachweis. Die erhaltenen Grobverdrahtungsdaten erlauben eine konkrete Vorauswahl, aber keine nachträgliche Freigabe des fehlenden Endlayouts.
Energieentscheidung und weitere Verwendung
Für die acht vermiedenen SRAM-Transaktionen lassen sich 810,9844 pJ interner Taktbogenenergie aus der Speicherbibliothek ableiten. Zusätzliche Steuerung, Direktverbindung, Taktlast und restliche Zellen fehlen in diesem Teilbetrag. Er ist keine Nettoenergieersparnis. Bei K = 64 dürfte die mittlere Leistung am gemeinsamen Takt höchstens etwa 4,10 % steigen, damit die kürzere Zeit überhaupt einen lokalen Energiegewinn ergibt.
Die Direktweitergabe bleibt als geprüfter Funktionsbaustein im Software- und RTL-Pfad erhalten. Der Versuch benennt zugleich den begrenzten Hebel: Eine kleine konstante Übergabekostenersparnis ersetzt keine Lösung für äußere Gewichtsbandbreite, größere Teilgraphen oder vollständige Systemenergie. Für weitere Vergleiche ist sie eine konkrete Ausgangsvariante mit reproduzierbaren Zugriffen, Protokollregeln und Taktzahlen.
Konsequenz für den nächsten Entwurf
Direkte Weitergabe als geprüften Baustein im verbundenen Software- und RTL-Pfad beibehalten.