
Forschungsbericht · veröffentlicht am 10. November 2026
Zusammenfassung
Wir vergleichen zwei Implementierungen einer Kachel mit vier Rechenlanes und vier lokalen FP32-Summenkontexten je Lane. Beide berechnen dieselbe fusionierte Operation aus zwei BF16-Operanden und einer FP32-Summe. Die Kontrollimplementierung verwendet die vollständige HardFloat-Funktion. Der Kandidat ersetzt darin die exakte ganzzahlige Produktbildung durch eine gemeinsam genutzte Tabelle von Teilprodukten. Exponentenausrichtung, Behandlung besonderer Zahlenwerte, Addition und abschließende Rundung bleiben enthalten.
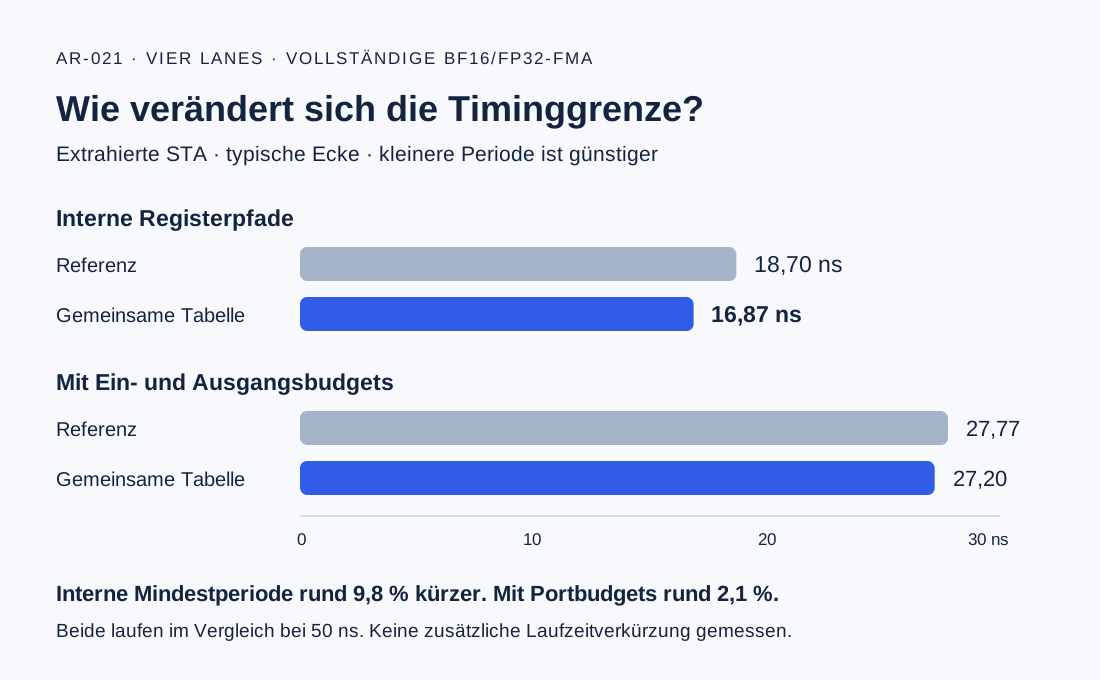
Im abgeschlossenen Layout beträgt die aus der extrahierten statischen Zeitanalyse abgeleitete interne Mindestperiode 18,70 ns bei der Kontrolle und 16,87 ns beim Kandidaten. Das entspricht einer Verkürzung um rund 9,8 Prozent. Bezieht man die festen Ein- und Ausgangsbudgets ein, sinkt die entsprechende Periode von 27,77 auf 27,20 ns, um rund 2,1 Prozent. Dem stehen 0,84 Prozent mehr Standardzellfläche und 7,01 Prozent mehr geroutete Leitungslänge gegenüber. Die Diefläche bleibt gleich.
Diese Werte beschreiben zwei konkrete vollständige Implementierungen bei einem typischen Prozessfenster. Beim vorgegebenen 50-ns-Takt arbeiten beide mit derselben Taktfrequenz. Eine kürzere Modellantwort oder niedrigere Energie pro Ergebnis wurde damit nicht gemessen. Beide finalen Standardzellnetzlisten bestehen denselben gezielten Funktionstest ohne Verzögerungen. Die statische Timinganalyse wird separat bewertet und ist auf eine typische Prozess-, Spannungs- und Temperaturecke begrenzt.
Welche Rechenarbeit wird geteilt?
Eine BF16-Aktivierung wird an alle vier Lanes übertragen. Jede Lane erhält ein eigenes BF16-Gewicht und führt ihre eigene FP32-Summe. Das passt zu einer Matrix-Vektor-Operation, bei der ein Eingabewert mehrere Ausgabekanäle beeinflusst. Der Versuch verändert weder die Gewichte noch die geforderte Ausgabegenauigkeit.
Für die Produktbildung bezeichnen a und b die vorzeichenlosen, normalisierten achtstelligen Signifikanden. Zerlegt man b in zwei Vier-Bit-Ziffern, gilt exakt:
a × b = (a × b_hi) × 16 + (a × b_lo).
Der Kandidat bildet die sechzehn Vielfachen a × d für d = 0 … 15 gemeinsam. Jede Lane wählt anhand ihres Gewichts zwei Einträge aus und setzt daraus ihr exaktes Produkt zusammen. Die Normalisierung einschließlich Subnormalzahlen erfolgt in der bestehenden Gleitkommalogik. Der Code nutzt die sechzehn bekannten nachlaufenden Nullbits der nach FP32 eingebetteten BF16-Signifikanden. Er ersetzt ausschließlich den entsprechenden Produktteil innerhalb der fusionierten Operation.
Das ist keine Quantisierung. Es gibt keinen zusätzlichen Rundungsschritt zwischen Multiplikation und Addition. Das Ergebnis wird weiterhin einmal auf FP32 mit Round-to-Nearest, Ties-to-Even gerundet. NaN, Unendlich, vorzeichenbehaftete Nullen, Subnormalzahlen und Ausnahmeflags bleiben Teil des Vertrags.
Die gemeinsame Berechnung kann Rechenlogik reduzieren oder anders strukturieren. Sie erzeugt gleichzeitig zusätzliche Verteilung und Auswahl. Ob daraus ein physischer Vorteil entsteht, hängt von Verdrahtung, Puffern, Lasten und dem kritischen Pfad ab. Genau diese Wechselwirkung motiviert den Layoutvergleich.
Lokale Summen und die Vergleichsgrenze
In beiden Varianten liegt die aktive FP32-Summe direkt an der Arithmetik. Drei weitere Summenkontexte werden in lokalen Registern gehalten. Beim Kontextwechsel tauscht der Controller die aktive Summe mit dem ausgewählten inaktiven Kontext. Bei aufeinanderfolgenden Operationen desselben Kontextes entfällt dieser Austausch. Die Ausgabe verwendet in beiden Varianten denselben Handshake und dieselbe Behandlung von Rückstau.
Der physische Top enthält kein Host-SRAM. Gewichtsversorgung, Modellzustände außerhalb der lokalen Register, Interconnect zwischen mehreren Kacheln und ein vollständiger Modellgraph sind nicht Bestandteil des gemessenen Ausschnitts. Der Vergleich untersucht daher die Integration von vollständiger FMA und lokalen Summen, nicht die Bandbreite eines Gesamtspeichersystems.
Die Kontrolle shared_fma4_baseline und der Kandidat shared_fma4_shared verwenden denselben lokalen Controller. Die Arithmetik- und Controllerquellen sind gegenüber dem vorangehenden funktionalen Entwurf unverändert. Der neue Top legt vier Lanes fest. Eine ebenfalls geroutete dritte Implementierung mit unabhängigen, speziell verkürzten Acht-Bit-Produkten fehlt. Aus dem Paarvergleich lässt sich deshalb nicht isolieren, welcher Anteil einer Änderung ausschließlich durch die gemeinsame Tabelle und welcher durch die andere Produktstruktur entsteht.
Physischer Versuchsaufbau
| Bedingung | Für beide Varianten |
|---|---|
| Prozessdaten | IHP SG13G2, typische Standardzellbibliothek |
| Spannung und Temperatur | 1,20 V und 25 °C |
| Taktsoll | 50 ns, entsprechend 20 MHz |
| Ein- und Ausgangsbudget | jeweils 10 ns |
| Ausgangslast und Taktunsicherheit | 0,01 pF und 0,1 ns |
| Diefläche | 1.000 × 1.000 µm, entsprechend 1 mm² |
| Kernfläche | 960 × 960 µm |
| Platzierungsdichte | 0,35 |
| Rechenressourcen des Entwurfswerkzeugs | acht Threads je Lauf |
| Werkzeugumgebung | festgeschriebener ORFS-Container und gehashte Werkzeuge, Skripte und Bibliothek |
Der Flow umfasst Synthese, Platzierung, Taktbaum, detaillierte Verdrahtung und RC-Extraktion. Die tatsächlich ausgeführten ABC-Mappingbedingungen wurden paarweise verglichen. In beiden Fällen scheiterte die vorgesehene SCL-Konvertierung, anschließend wurde derselbe direkte Liberty-Weg genutzt. Treiber, Last, Bibliotheksdatei und Ausschlussliste sind übereinstimmend dokumentiert. Die ursprüngliche Datei abc.constr wurde nicht separat archiviert. Die tatsächlich geladene Treiber- und Lastangabe stammt aus der ABC-Ausgabe und den festgeschriebenen Eingangsdaten. Ein Vergleich unterschiedlicher Synthesestrategien wird daraus nicht abgeleitet.
Die Worker quittieren 1.375,70 Sekunden für die Kontrolle und 1.404,39 Sekunden für den Kandidaten. Das sind Laufzeiten des Entwurfswerkzeugs von etwa 23 Minuten, keine Ausführungszeiten der Kachel. Die Sammlung enthält 129 beziehungsweise 130 hashgeprüfte Ergebnisdateien. Die im Versuch reservierten vier Euro sind eine Planungsobergrenze und keine vorliegende Schlussrechnung.
Ergebnisse nach Verdrahtung
Prozentwerte beziehen sich jeweils auf die Kontrolle. Die Periodenangaben sind aus den archivierten Berichten auf zwei Dezimalstellen übernommen. Daraus berechnete Prozentwerte besitzen keine höhere physische Genauigkeit.
| Größe | Kontrolle | Gemeinsame Tabelle | Änderung |
|---|---|---|---|
| Interne Mindestperiode, Register zu Register | 18,70 ns | 16,87 ns | −9,79 % |
| Mindestperiode einschließlich Portbudgets | 27,77 ns | 27,20 ns | −2,05 % |
| Standardzellfläche | 286.929 µm² | 289.346 µm² | +0,84 % |
| Diefläche | 1.000.000 µm² | 1.000.000 µm² | 0 % |
| Geroutete Leitungslänge | 1.202.331 µm | 1.286.641 µm | +7,01 % |
| Größter berichteter Signalfanout nach Reparatur | 8 | 8 | gleich |
| Summe der SPEF-Netzkapazitäten | 194,3377 pF | 214,7419 pF | +10,50 % |
| Setup-Slack bei 50 ns | 22,2294 ns | 22,8040 ns | positiv bei beiden |
| Hold-Slack | 0,1685 ns | 0,1673 ns | positiv bei beiden |
Die minimale interne Periode beschreibt den Register-zu-Register-Pfad im verwendeten Timingmodell. Ihre reziproke Änderung entspräche rechnerisch 10,85 Prozent mehr interner Frequenzreserve. Das ist keine bereits gefahrene höhere Betriebsfrequenz. Die Ein- und Ausgänge haben eigene Zeitbudgets und begrenzen die Schnittstelle anders. Für die tatsächlich untersuchte Konfiguration bleiben 50 ns und damit die Zahl der Takte pro identischer Auftragsfolge unverändert.
Standardzellfläche bezeichnet die Summe belegter Zellen. Sie ist nicht mit Diefläche oder Herstellungskosten gleichzusetzen. Ebenso ist die Summe der in SPEF berichteten Netzkapazitäten keine aktivitätsgewichtete Schaltkapazität. Ohne Umschalthäufigkeiten, Glitches, interne Zellleistung, Leckleistung und konsistente Messgrenze lässt sich daraus kein Energieverbrauch ableiten. Die zusätzliche Leitungslänge und Kapazität sind konkrete Gründe, einen Energievorteil gesondert zu prüfen.
Warum die Timingqualifikation einen eigenen Audit benötigt
Die unveränderte strenge Auswertung der ursprünglichen Berichte setzt timing_usable=false. Ursache sind fünf beziehungsweise sechs als nicht annotiert gemeldete Ausgänge zusätzlich eingefügter Taktlastzellen. Diese Ausgangspins sind in der finalen Netzliste tatsächlich unverbunden. Ihre Eingangspins hängen dagegen am realen Taktbaum und müssen mit ihren Lasten erhalten bleiben.
annotation-audit-qualified.json prüft diese Zuordnung für jeden gemeldeten Pin anhand von finaler Netzliste, Liberty-Pinrichtung, Verbindungsliste und extrahiertem RC-Netz. Die Eingangslasten sind im Taktbaum enthalten und über das Widerstandsnetz erreichbar. Drei gezielte Gegenproben je Variante werden abgewiesen: ein doch verbundener Ausgang, ein fehlender Takteingang und eine unterbrochene RC-Verbindung.
Die zusätzliche Qualifikation erlaubt deshalb einen begrenzten Vergleich unter dieser explizit geprüften Ausnahme. Sie ändert weder SDC noch die ursprünglichen Berichte und erklärt nicht pauschal alle fehlenden Annotationen für unbedenklich. Die ursprüngliche Vergleichsdatei bleibt mit ihrer strengen negativen Qualifikation erhalten. Der Audit ist ein zusätzlicher Nachweis, kein nachträgliches Überschreiben des Ergebnisses.
Detailliertes Routing meldet bei beiden Varianten null DRC- und Antennenverletzungen. Die ausgewerteten elektrischen Zähler für Fanout, Flankensteilheit, Kapazität sowie Setup und Hold stehen ebenfalls auf null. Die Versorgungskonnektivität für VDD und VSS besteht. Diese Prüfungen ersetzen weder belastete IR-Drop- und Elektromigrationsanalysen noch einen vollständigen Fertigungs-Signoff.
Die finalen Netzlisten bestehen die gezielte Funktionsprüfung
Vor dem Layout wurden die exakt verwendeten Vier-Lane-Tops gegen eine unabhängige ganzzahlige FMA-Referenz geprüft. Nach der Verdrahtung besteht dieselbe Sollspur auf beiden finalen Standardzellnetzlisten. Je Variante werden 163 Befehle, 272 einzelne Lane-FMAs, 77 Ausgabeereignisse und 19 Resets geprüft. Ein Ausgabeereignis vergleicht alle vier FP32-Werte und die zugehörigen Ausnahmeflags.
Die Spur enthält fusionierte Überlaufkompensation, Subnormalgrenzen, NaN und Unendlich, dynamische Gewichte, vier dauerhafte Kontexte und Ausgabe-Rückstau. Jede Rechenanforderung wird durch eine anschließende Ausgabe beobachtbar. Der Vergleich greift ausschließlich auf die äußeren Ports zu. Eine absichtlich um ein Bit verfälschte Sollausgabe führt bei beiden Netzlisten zum erwarteten Abbruch. Damit wird auch kontrolliert, dass der Sollvergleich tatsächlich anschlägt.
Die Abnahme verknüpft Netzlisten-, Testbench-, Zellmodell- und Spurhashes mit den beiden gerouteten Layoutarchiven. Es gibt keinen Rückfall auf das ursprüngliche RTL. Die IHP-Zellmodelle und Icarus Verilog 12.0 sind mit ihren Dateihashes dokumentiert. Die vollständigen Netzlisten und Zellmodelle sind im kleinen öffentlichen Nachweispaket nicht enthalten.
Die Simulation arbeitet ohne annotierte Laufzeitverzögerungen. Die 100-ns-Testbench-Periode ist eine Ablaufhilfe des Simulators, keine gemessene Schaltungsperiode und kein Ersatz für den getrennten 50-ns-STA-Vertrag. Die 272 Lane-FMAs sind gezielte Fälle, keine erschöpfende Prüfung aller Zahlenkombinationen. Die Abnahme ist weder ein formaler Äquivalenzbeweis noch eine SDF-Simulation.
Frühere fehlgeschlagene Infrastrukturversuche wurden erhalten. Der erfolgreiche Linux-Lauf ersetzt deren Status nicht rückwirkend. Eine unvollständige Ausführung zählt weiterhin nicht als Nachweis.
Einordnung und nächster Erkenntnisgewinn
Der Versuch beantwortet eine eng umrissene Integrationsfrage: Der Kandidat erreicht innerhalb einer vollständigen FMA mit lokalen Summen ein kürzeres internes Timingmodell bei weitgehend gleicher Zellfläche, während Verbindungsaufwand zunimmt. Die Grenze eines isolierten Produktgeneratorvergleichs wird dadurch in Richtung einer vollständigen Rechenkachel verschoben. Ein günstigeres isoliertes Produkt lässt sich nicht automatisch auf diese Integration übertragen, weshalb der vollständige Vergleich erforderlich ist.
Vier Lanes sind weder ein Ersatz für einen abgeschlossenen 32-Lane-Vergleich noch ein Beleg für Skalierbarkeit. Ein einzelner Platzierungs- und Routinglauf je Variante liefert keine Streuungsverteilung. Prozess-, Spannungs- und Temperaturvariationen, mehrfache Layoutseeds, Aktivität und größere Lanezahlen sind nicht geprüft. Eine Verallgemeinerung auf gesamte Modelle, Training oder marktführende Beschleuniger wäre deshalb nicht durch diesen Datensatz gedeckt.
Nach der bestandenen gezielten Funktionsabnahme ist ein sinnvoller Folgeversuch die vorab spezifizierte Suche über Kernform und Platzierungsdichte. Sie kann zeigen, ob die Verteilung des gemeinsamen Signals und die örtliche Anordnung der Summen das Timing weiter verbessern oder ob der Verbindungsaufwand den Ansatz begrenzt. Der unabhängige Acht-Bit-Produktpfad bleibt eine wichtige spätere Ablation, um die Ursache des Effekts genauer zu trennen. Für einen Energienachweis braucht es eine identische Lastspur, Schaltaktivitäten und ein vollständigeres Leistungsmodell.
Daten und Nachrechnung
Das gesonderte Datenpaket zu AR-021 enthält unveränderte Abschlussmetriken und Timingberichte beider Layouts, den begrenzten CTS-Audit, originale Positiv- und Negativlogs sowie die geprüfte Sollspur und Testbench. Die Vergleichsdaten und kuratierte Abnahmequittung sind auch einzeln verfügbar.
Nach dem Entpacken prüft python verify_fma4.py --require-final die Dateiintegrität, die Bindung an die mitgelieferten Ausgangsdaten, Prozentrechnungen und die dokumentierten Abnahmekriterien. Mit --self-test werden zusätzlich veränderte Perioden, Netzlistenidentitäten, Negativkontrollen und unvollständige Abnahmestände absichtlich zurückgewiesen.
Die Originale der kuratierten Zusammenfassung und Abnahme sind anhand ihrer SHA-256-Identitäten benannt. Betriebskennungen wurden weggelassen. Die vollständigen nativen Layoutarchive, finalen Verilog-Netzlisten und Zellmodelle gehören nicht zum Download. Der Offlineprüfer startet deshalb weder eine neue Verdrahtung noch einen erneuten Netzlistenlauf. Er prüft die veröffentlichten Daten und Belege. Eine Prüfsumme allein ist kein unabhängiger Nachweis für den Inhalt eines nicht mitgelieferten Artefakts.
Grundlagen der verwendeten Werkzeuge: Berkeley HardFloat, OpenROAD und IHP Open PDK. Sie sind Werkzeuggrundlagen dieses Versuchs, keine Projektpartner.
Konsequenz für den nächsten Entwurf
Die vollständige Vier-Lane-Kachel bleibt ein Kandidat für kurze lokale Rechenwege. Als nächster kontrollierter Versuch folgt eine vorab festgelegte Suche über Kernform und Platzierungsdichte. Ein unabhängiger Acht-Bit-Produktpfad soll anschließend den kausalen Beitrag des Teilens abgrenzen. Weitere Betriebsecken, Layoutseeds und Aktivitätsdaten müssen die Stabilität und energetischen Kosten des Timinggewinns klären.