
Forschungsbericht · veröffentlicht am 10. November 2026
Die Frage beginnt vor der Matrixmultiplikation
Ein quantenmechanischer Rechenweg muss seine Modellgewichte in eine geeignete Operation einbinden. Ein klassisch gespeicherter Zahlenvektor steht nicht kostenlos als Quantenzustand oder als kohärent abrufbarer Speicher zur Verfügung. Eine bloße Übersetzung einer Matrixmultiplikation in eine Quantenschaltung überspringt deshalb einen entscheidenden Aufwand.
Wir setzen AlphaEvolve an einem kleineren, vollständig prüfbaren Teilproblem ein: einer reversiblen Nachschlagefunktion. Sie soll für eine Adresse das zugehörige kleine Gewicht in ein Datenregister einblenden. Die KI darf die konkrete Gatterfolge verändern, aber nicht die Funktion oder die verfügbaren Qubits. Das Ziel ist ein messbarer Algorithmusunterschied unter einem klaren Vertrag.
Elf logische Qubits und ein vollständiger Funktionsvertrag
Die Aufgabe enthält vier Adressqubits, vier Datenqubits und drei anfangs auf null gesetzte Hilfsqubits. Die feste synthetische Tabelle lautet:
W = [9, 2, 14, 7, 1, 12, 6, 11, 4, 15, 0, 8, 13, 3, 10, 5]
|a, y, 000> → |a, y XOR W[a], 000>
Alle 16 Adressen und alle 16 Anfangswerte des Datenregisters sind erlaubt. Die drei Hilfsqubits müssen nach dem Abruf wieder null sein. Auch die Adresse muss erhalten bleiben. Damit prüfen wir nicht nur den bequemeren Sonderfall eines anfangs leeren Datenregisters.
Eine zulässige Gatterfolge verwendet ausschließlich X, CNOT und Toffoli. Diese Gatter beschreiben phasenfreie reversible Permutationen. Gleichheit für alle 256 Basiszustände des zulässigen Unterraums impliziert deshalb dieselbe Abbildung für jede Superposition in diesem Unterraum. Die Aussage gilt nicht für beliebig initialisierte Hilfsqubits und nicht für allgemeine Schaltungen mit zusätzlichen Phasen oder Messungen.
Was die Suche tatsächlich minimiert
Die vorab festgelegte Zielfunktion bevorzugt weniger Toffoli-Gatter. Bei gleicher Toffoli-Zahl entscheiden CNOT- und anschließend X-Gatter:
Kosten = 7 × Toffoli + CNOT / 1000 + X / 1000000
Score = 1 / Kosten
Der Faktor sieben stammt aus einer üblichen exakten T-Gatter-Zerlegung eines Toffoli. Er ist hier eine deklarierte Bewertungsreferenz. Andere Zerlegungen, Hilfsqubits, Messungen und Fehlerkorrektur können andere Ressourcen benötigen. Der Score ist weder Joule noch Nanosekunden. Die logische Tiefe wird zusätzlich ausgewiesen, aber in diesem Versuch nicht optimiert.
Alle drei Gattertypen werden mit gleicher logischer Schrittdauer in die Tiefenberechnung aufgenommen. Das ist eine idealisierte Abhängigkeitszählung ohne Konnektivitäts-, Routing- und Fehlerkorrekturkosten. Eine geringere Tiefe begründet deshalb noch keine physische Geschwindigkeitsaussage.
Klassischer Ausgangspunkt und native KI-Suche
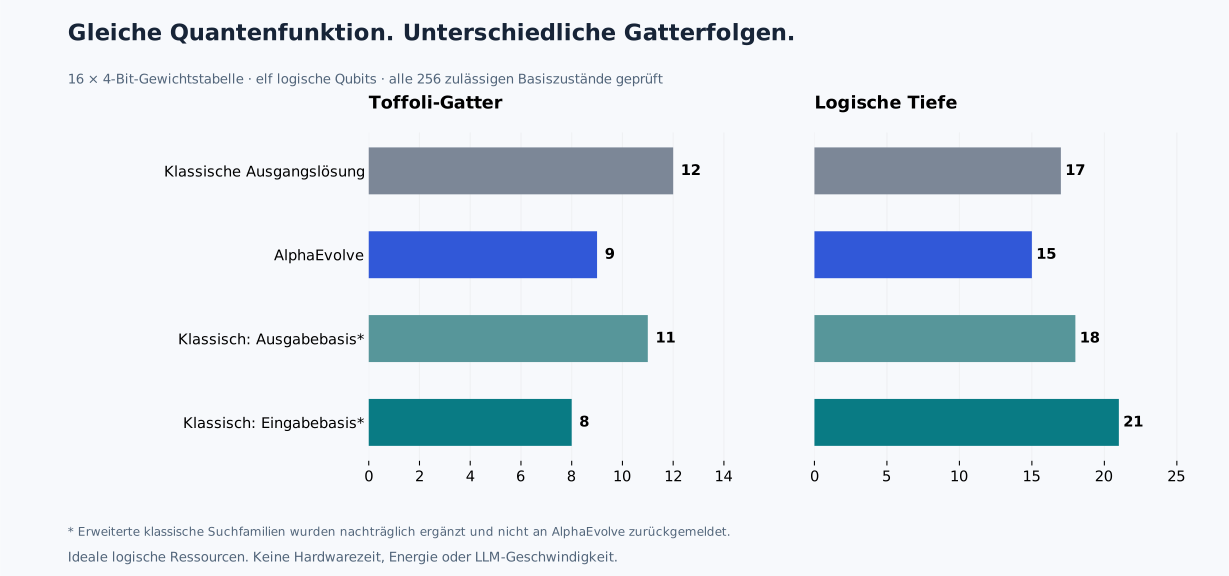
Vor dem Start erzeugt ein klassischer Generator 352 korrekte Gatterfolgen. Er variiert alle 16 Eingangspolaritäten und 22 Möglichkeiten, bis zu zwei quadratische Terme gemeinsam zu berechnen. Seine beste Lösung benötigt zwölf Toffoli-Gatter. Diese Suche dauert lokal 0,268 Sekunden. Die Zeit beginnt beim Aufruf des bereits entwickelten Generators.
Der native AlphaEvolve-Lauf verwendet Gemini 4 Argon MEDIUM. Er erhält die Ausgangslösung, den Funktionsvertrag und nach jedem ausgewerteten Vorschlag das tatsächliche Prüfergebnis. Das vorab begrenzte Budget umfasst höchstens sechs neue Vorschläge, 30 Minuten Dienstlaufzeit und eine konservative Modellkostenreserve von vier Euro. Eine zusätzliche Rückmeldeschwelle bei zwei Euro begrenzt weitere Vorschläge.
Tatsächlich wurden 2 neue Vorschläge extern ausgewertet. Der Dienst ist abschließend inaktiv bestätigt, mit Status PAUSED. Alle ausgewerteten Scores wurden vom Dienst zurückgelesen. Das maximale Sechserbudget wurde in diesem zeitbegrenzten Lauf nicht ausgeschöpft. Es handelt sich um einen Suchverlauf auf einer Tabelle, nicht um eine Erfolgsstatistik über viele unbekannte Aufgaben.
Das Ergebnis: Gatterzahl und Tiefe getrennt betrachten
| Verfahren | Toffoli | CNOT | X | Tiefe | Kostenfunktion |
|---|---|---|---|---|---|
| Klassische Ausgangslösung | 12 | 10 | 6 | 17 | 84,010006 |
| Bester KI-Vorschlag | 9 | 12 | 3 | 15 | 63,012003 |
| Klassisch: Ausgabebasis, nachträglich | 11 | 12 | 6 | 18 | 77,012006 |
| Klassisch: Eingabebasis, nachträglich | 8 | 17 | 5 | 21 | 56,017005 |
Gegenüber der festgelegten Ausgangslösung sinkt die Toffoli-Zahl des besten KI-Vorschlags um 25,00 %. Die Funktionsgleichheit bleibt vollständig erhalten. Die stärkere klassische Eingabebasis hat unter der festgelegten Kostenfunktion den besseren Wert. Die logischen Tiefen unterscheiden sich ebenfalls. Eine Variante kann weniger teure Gatter und trotzdem einen längeren Abhängigkeitspfad besitzen.
Die Reihenfolge der Bewertung bleibt verbindlich: Zuerst zählt die vorab festgelegte Kostenfunktion. Die Tiefe ist ein zusätzlicher Zielkonflikt und darf nicht nachträglich zum neuen Hauptziel erklärt werden, nur um einen gewünschten Sieger zu erhalten.
Warum die stärkere klassische Kontrolle dazugehört
Nach den ersten KI-Ergebnissen haben wir zwei größere klassische Suchfamilien ergänzt. Eine variiert die lineare Basis der vier Datenbits, die andere die lineare Basis der vier Adressbits. Es gibt jeweils 20.160 invertierbare binäre Vier-Bit-Transformationen. Zusammen mit 16 Polaritäten und 22 Mengen zwischengespeicherter Terme ergeben sich je 7.096.320 Kostenmodelle.
Die Umrechnung hin zur neuen Basis und wieder zurück wird vollständig mitgezählt. Besonders beim Datenregister wäre es falsch, die Rückumrechnung nur für einen Anfangswert von null zu prüfen. Die Eingabebasis muss ihrerseits die ursprüngliche Adresse wiederherstellen. Die Gewinner beider Familien bestehen die vollständigen unabhängigen Funktionsprüfungen.
Die Ausgabebasis-Suche benötigt lokal 2,040 Sekunden, die Eingabebasis-Suche 1,950 Sekunden. NumPy wertet die Gatterzählmodelle vektorisiert aus. Das sind keine Millionen einzeln ausgeführten Quantensimulationen. Nur ausgewählte beste Gatterfolgen werden materialisiert und geprüft. Beide Familien werden getrennt durchsucht, nicht ihr vollständiges Kreuzprodukt.
Diese Kontrollen sind nachträglich hinzugekommen. Ihre Ergebnisse wurden nicht an die laufende native Suche weitergegeben. Sie stärken die technische Einordnung, sind aber kein vorab festgelegter, budgetgleicher KI-Wettbewerb. Auch ihre Entwicklungszeit ist in den kurzen CPU-Laufzeiten nicht enthalten.
Zwei unabhängige Prüfwege statt Vertrauen in den Score
Der laufende Evaluator simuliert alle 256 erlaubten Eingaben parallel über ganzzahlige Bitmasken. Eine zweite Implementierung verfolgt jeden Zustand einzeln. Sie prüft außerdem die Bijektivität der vollständigen 2.048-Zustands-Abbildung. Eine dritte Rechnung wendet die Gatter durch paarweise Vertauschungen auf einen komplexen Zustandsvektor an und vergleicht das Ergebnis einer reproduzierbaren zufälligen Superposition mit der direkten Sollabbildung.
Vier absichtlich beschädigte Schaltungen verändern Daten, Adresse, Hilfsqubits oder das Verhalten bei einem anfangs nicht leeren Datenregister. Beide Funktionsprüfer müssen diese Fehler erkennen. Dreizehn unerlaubte Quelltextformen prüfen zusätzlich den Parser. Der generierte Text wird ausschließlich als literale Gatterliste eingelesen. Er wird nicht als Python-Programm ausgeführt.
Diese Prüfungen bestätigen die ideale logische Funktion. Sie simulieren keine Rauschprozesse und keine reale Quantensteuerung. Die komplexe Stichprobe ergänzt den vollständigen Basisbeweis. Sie ersetzt ihn nicht.
Was dieser Baustein für ein Sprachmodell bedeuten könnte
Ein kohärenter Gewichtsabruf kann ein Bestandteil eines Quantenalgorithmus sein. Damit aus seiner Verbesserung ein schnelleres LLM wird, müssten zusätzlich eine passende Modellabbildung, Zustandsvorbereitung, nichtlineare Operationen, Ergebnisgewinnung und Fehlerkorrektur mitgerechnet werden. Qualität, Latenz und Energie müssten schließlich bei gleicher Aufgabe gegen eine starke klassische Ausführung gemessen werden.
Die Tabelle dieses Versuchs ist fest. Ihre Gewichte werden in eine Gatterfolge kompiliert. Neue Gewichte verlangen deshalb eine neue Gatterfolge und deren Bereitstellung. Ein programmierbarer Quantenprozessor könnte das ohne einen neuen Chip laden. Der Kompilierungs- und Programmieraufwand wäre aber Teil der Bilanz. Eine kostenlose, beliebig große QRAM wird nicht vorausgesetzt.
Für einen einzelnen klassischen Vier-Bit-Tabellenzugriff ist eine gewöhnliche Nachschlagetabelle eine naheliegende Referenz. Hier wurde kein Zeitvergleich damit durchgeführt. Die Motivation des Quantenbausteins liegt im kohärenten Einsatz innerhalb eines geeigneten Quantenalgorithmus, nicht in einem behaupteten Vorteil des isolierten kleinen Abrufs.
Forschungsstand und andere zulässige Ansätze
Die Literatur untersucht bereits den Austausch von T-Gattern gegen zusätzliche Hilfsqubits bei Datenbereitstellung. Low, Kliuchnikov und Schaeffer beschreiben solche Ressourcenverhältnisse. Neuere QROM-Verfahren mit dichter Kodierung verwenden weitere Freiheitsgrade, die unser X/CNOT/Toffoli-Suchraum nicht enthält. Ein negatives Ergebnis in diesem kleinen Suchraum widerlegt diese Verfahren nicht.
Ein Quantum-Transformer-Ansatz untersucht andere Ein- und Ausgabeverträge auf einer fehlertoleranten Architektur. Solche theoretischen Resultate sind Anknüpfungspunkte für zukünftige Ressourcenanalysen. Sie sind keine Messung eines schneller laufenden Qwen-Modells in unserem Versuch.
Auch AlphaEvolves klassische Matrixmultiplikationssuche und seine berichteten Anwendungen an Quantenschaltungen sind verschiedene Aufgaben. Weniger klassische Multiplikationen und weniger logische Quantengatter können beide nützlich sein. Zwischen beiden Ergebnissen existiert aber kein automatischer Übersetzungsschritt zu einem überlegenen LLM-System.
Aufwand, Eingriff und reproduzierbare Veröffentlichung
Die abschließenden Tokenzähler ergeben eine konservative Modellkostenschätzung von 0,904896 EUR. Sie verwendet 12 USD je Million Eingabetokens und 60 USD je Million Ausgabetokens mit dem Planungsfaktor 1,5 EUR je USD. Dieser Faktor ist eine Reserve, kein Wechselkurs. Die Zahl ist keine Rechnungsprüfung. Lokale Entwicklung, Codex-Nutzung und CPU-Zeit sind nicht darin enthalten.
Vor dem nativen Start wurde eine Konfigurationsprüfung korrigiert: Der Dienst lässt ein skalares Nullfeld in seiner Rückgabe weg. Das unveränderte leere Experiment wurde anschließend unter demselben Vertrag fortgesetzt. Zu diesem Zeitpunkt war noch kein Vorschlag generiert. Der Eingriff ist im veröffentlichten Ablauf vermerkt.
Das Nachweispaket enthält alle ausgeführten Gatterfolgen, klassische Generatoren, Vergleichszahlen und unabhängige Prüfer. Mit python verify_quantum.py --self-test lassen sich Funktion, Kennzahlen und Negativkontrollen ohne Cloudzugang wiederholen. Die native Suche selbst wird dadurch nicht erneut ausgeführt.
Die nächste wissenschaftliche Entscheidung
Der Versuch rechtfertigt es, exakte Ressourcenoptimierung weiter zu untersuchen. Er liefert einen konkreten Quantenbaustein und einen stärkeren klassischen Generator für dieselbe Funktion. Ein nächster Versuch sollte mehrere bislang unbekannte Tabellen und Größen verwenden, ein vorab festgelegtes Gatter- und Tiefenziel sowie dieselbe Zeit- und Kostenbilanz für alle Verfahren.
Vor einem größeren LLM-Experiment ist außerdem eine vollständige Ressourcenabschätzung nötig, die eine kohärente Einbettung tatsächlich nutzt. Der derzeitige Befund ist eine überprüfte Schaltungsoptimierung. Eine Beschleunigung oder Energieeinsparung eines vollständigen Sprachmodells auf Quantenhardware wurde nicht gemessen.
Konsequenz für den nächsten Entwurf
Klassische und KI-Gatterfolgen nach Gatterzahl und Tiefe vergleichen. Vor größerem Modelltest Datenbereitstellung, Fehlerkorrektur und Qualitätsvertrag explizit einbeziehen.