
Forschungsbericht · veröffentlicht am 10. November 2026
Die Forschungsfrage: bessere Schaltungen statt kürzerer Quelltexte
Eine KI kann viele mathematisch gleichwertige Schreibweisen einer Multiplikation vorschlagen. Für den Chipentwurf ist entscheidend, welche Schaltung die Synthese daraus erzeugt. Weniger Verilog-Zeilen bedeuten weder weniger Standardzellen noch einen kürzeren kritischen Pfad. Wir untersuchen deshalb, ob eine rückgekoppelte AlphaEvolve-Suche einen bereits optimierten klassischen Produktgenerator unter unveränderter Rechenfunktion verbessert.
Die abgegrenzte Aufgabe ist eine kombinatorische Bank aus vier Multiplikationen mit einem gemeinsamen Eingang. Sie sitzt innerhalb unseres Ansatzes für BF16-Multiplikation, FP32-Akkumulation und lokale laufende Summen. In diesem Versuch darf ausschließlich der Produktgenerator verändert werden. Schnittstelle, Genauigkeit, Prüfer und Bewertungsverfahren bleiben fest. Das Ergebnis soll einen begründeten Kandidaten für den anschließenden physischen Vergleich auswählen.
Ein Vertrag für alle 40 Eingangsbits
Der Eingang a besitzt acht Bits. Der Eingang b enthält vier unabhängige Acht-Bit-Werte. Für jede Lane i = 0, 1, 2, 3 muss der sechzehn Bit breite Ausgang genau dem vorzeichenlosen Produkt entsprechen:
p[16*i +: 16] = unsigned(a) * unsigned(b[8*i +: 8])Alle Eingänge dürfen jeden Wert von 0 bis 255 annehmen. Die vier Produkte müssen vollständig definiert sein. Zustand, versteckte Tabellen mit eingeschränktem Eingangsbereich, zusätzliche Dateien oder Änderungen der Ports sind nicht zulässig. Die Gewichte bleiben veränderbar. Die Optimierung setzt kein fest eingebranntes Modell voraus.
Der Funktionstest hat drei Stufen. Zuerst beweisen vier SAT-Prüfungen die Gleichheit jeder Produkt-Lane. Dabei bleiben in jeder Prüfung alle 40 Eingangsbits frei. Anschließend wird der Produktgenerator in die vollständige FMA-Arithmetik eingesetzt und gegen gezielte Sollspuren geprüft. Schließlich muss eine absichtlich falsche Sollspur einen Fehler auslösen. Eine bestandene Produktprüfung allein wird nicht als formaler Beweis der vollständigen Gleitkommaeinheit ausgegeben.
Was Fläche und Verzögerung in diesem Versuch bedeuten
Nach bestandener Funktionsprüfung bildet Yosys den Produktgenerator auf Standardzellen des Prozesses IHP SG13G2 ab. OpenROAD ermittelt die kombinatorische Ankunftszeit unter festen Bedingungen. Verwendet werden die typische Bibliotheksecke bei 1,20 V und 25 °C, ein Eingangstreiber sg13g2_buf_4 und 0,006 pF Ausgangslast.
Die Fläche A ist die Summe der abgebildeten Zellflächen in µm². Die Verzögerung D ist die Ankunftszeit im festgelegten Zellmodell in ns. Verbindungen besitzen in diesem schnellen Bewertungsverfahren noch keine extrahierten Leitungsparasitiken. Das Produkt A × D, kurz ADP, dient als Auswahlkennzahl. Es ist weder die Energie eines Rechenschritts noch die Laufzeit einer vollständigen Kachel.
Diese Begrenzung ist für die Suche wesentlich. Eine neue Faktorisierung kann Logik sparen und zugleich den Fanout erhöhen. Erst Platzierung und Verdrahtung zeigen, welche zusätzlichen Puffer und Leitungsverzögerungen dadurch entstehen. Die hier beschriebene Auswahl wird deshalb nicht nachträglich mit Ergebnissen einer anderen physischen Messgrenze vermischt.
Zwei Zielfunktionen mit vorab festgelegten Grenzen
Die Suchen A1 und A2 minimieren A × D. Beide Einzelgrößen dürfen höchstens das 1,25-Fache der natürlichen Multiplikationsreferenz betragen. Ein gültiger Vorschlag erhält den Score 1 / (A × D). Die Suchen B1 und B2 minimieren dagegen die Fläche bei einer festen Verzögerungsobergrenze von 2,243918896 ns. Diese Grenze entspricht der starken klassischen Ausgangslösung. Ihr gültiger Score lautet 1 / A.
Ein mathematisch falscher Entwurf, eine fehlgeschlagene Bewertung oder eine verletzte Grenze führt zur Ablehnung. Die negative Bewertung wird nicht durch einen erfundenen Ersatzmesswert kaschiert. Die beiden Zielfunktionen werden getrennt ausgewertet. Ein kleinerer, aber für B zu langsamer Entwurf darf nicht im Nachhinein zum B-Sieger erklärt werden. Zusätzlich galt eine 5-%-Verringerung des ADP als vorab gesetzte Erfolgsschwelle für das Screening. Sie wurde in dieser Kampagne nicht erreicht. Diese Schwelle war keine Voraussetzung für den ersten vollständigen Layoutvergleich des besten gültigen Kandidaten.
Eine starke klassische Referenz und ein faires Vorschlagsbudget
Die Ausgangsbasis umfasst neun bereits ausgewertete klassische Varianten. Hinzu kommen 16 neue systematisch erzeugte Kombinationen aus Teilproduktzerlegung, Kompressionsbaum und abschließender Addition. Untersucht werden unter anderem binäre, Radix-4- und gemischte Zerlegungen, Wallace- und Dadda-Bäume sowie inferierte und explizite Brent-Kung-Additionen. Die beste historische Variante bleibt auch gegenüber diesen 16 neuen Entwürfen die stärkste ADP-Referenz.
Die stärkste Ausgangslösung verwendet einen balancierten binären Teilproduktbaum. Der klassische Vergleichsbestand enthält außerdem Radix-Varianten mit gemeinsam genutzten Vielfachen. Der KI-Vorteil wird damit gegen die beste geprüfte Ausgangslösung dieses Bestands und nicht nur gegen vier unmittelbar ausgeschriebene Multiplikationen berechnet. Die feste Reihenfolge der 16 neuen klassischen Kandidaten ermöglicht Vergleiche nach acht und nach sechzehn Vorschlägen. Die insgesamt 24 Vorschläge einer KI-Suche sind kein gleich großes Budget wie 16 klassische Vorschläge.
Die native AlphaEvolve-Kampagne umfasst zwei Wiederholungen pro Zielfunktion mit jeweils 24 neuen Vorschlägen. Eingesetzt wird Gemini 4 Argon MEDIUM über den verwalteten Dienst. Acht weitere Läufe erzeugen jeweils genau einen neuen Vorschlag aus derselben Ausgangsbasis. Diese isolierten Kontrollen erhalten keine nachfolgende Verbesserungsschleife. Zusammen sind das 96 Vorschläge aus vier rückgekoppelten Suchen und acht Kontrollen.
Duplikate und gescheiterte Vorschläge zählen zum Budget. Identischer Quelltext darf bereits vorhandene Werkzeugbelege aus dem Cache verwenden. Das spart einen erneuten Werkzeuglauf, entfernt aber weder den Vorschlag noch seine Modellkosten aus der Bilanz. Unterschiedliche Quelltext-Hashes sind außerdem kein Beweis für unterschiedliche Architekturen.
Das Ergebnis der vier vollständigen Suchen
| Suche | Ziel | Neue Vorschläge | Gültig | Entscheidung |
|---|---|---|---|---|
| A1 | ADP | 24 | 23 | Klassische Ausgangslösung behalten |
| A2 | ADP | 24 | 18 | Vorschlag 8 auswählen |
| B1 | Fläche bei fester Timinggrenze | 24 | 0 | Klassische Ausgangslösung behalten |
| B2 | Fläche bei fester Timinggrenze | 24 | 0 | Klassische Ausgangslösung behalten |
A2 erreicht mit Vorschlag 8 den niedrigsten gültigen ADP-Wert der Kampagne. Die folgenden sechzehn Vorschläge verbessern ihn nicht weiter. A1 findet keinen Entwurf, der die klassische Ausgangslösung schlägt. In B1 und B2 entstehen zwar kleinere Varianten, aber keine hält die feste Timinggrenze ein. Der flächenkleinste B1-Entwurf benötigt ungefähr 12,74 % mehr Verzögerung als die Referenz. Bei B2 sind es ungefähr 23,78 %. Der Zielkonflikt wird damit sichtbar und nicht aus der Ergebnisliste entfernt.
Die Verbesserung ist klein, konkret und nachrechenbar
| Größe | Klassische Referenz | A2, Vorschlag 8 | Änderung |
|---|---|---|---|
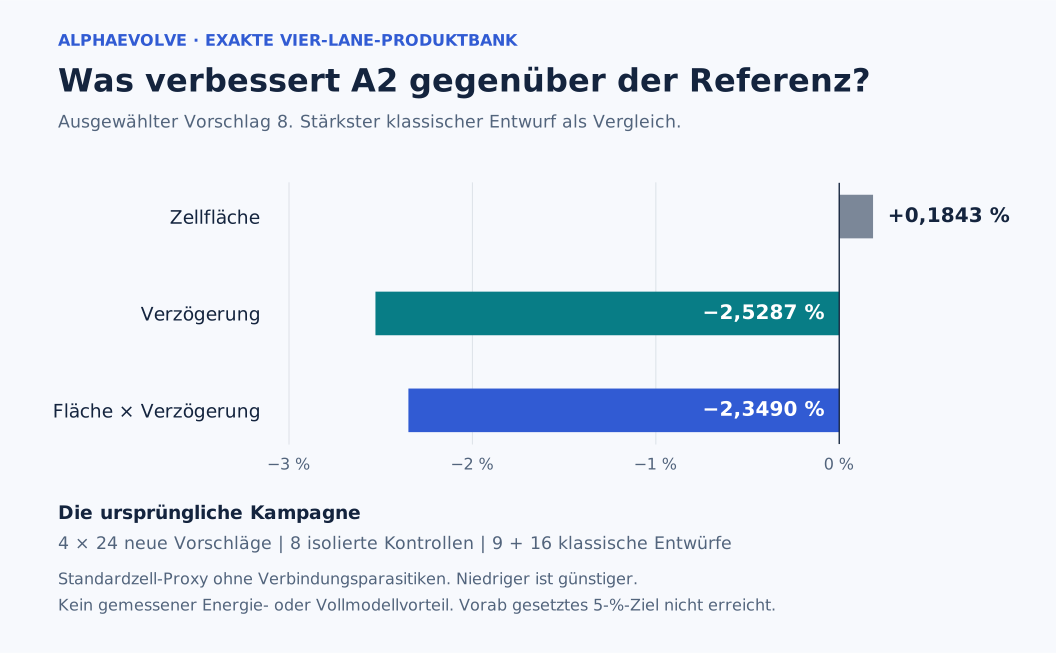
| Zellfläche | 17.757,873 µm² | 17.790,6078 µm² | +0,1843 % |
| Verzögerung | 2,243918896 ns | 2,187176466 ns | −2,5287 % |
| Fläche × Verzögerung | 39.847,226777468204 µm²·ns | 38.911,198695996034 µm²·ns | −2,3490 % |
Die Verringerung berechnet sich aus 100 × (1 − 38911,198695996034 / 39847,226777468204). Die zusätzlichen Stellen machen die Rechnung reproduzierbar. Sie sind keine Aussage über eine entsprechend hohe physikalische Messgenauigkeit.
Der ausgewählte Entwurf besteht die Produktbeweise und die gezielte vollständige FMA-Prüfung mit 163 Kommandos, 272 FMA-Operationen, 77 Ausgaben und 19 Resets. Die absichtlich verfälschte Sollspur wird erkannt. Das dokumentiert die Funktion innerhalb dieser Prüfungen. Für einen vollständigen Funktionsbeweis der gesamten FMA oder ein fertigungstaugliches Gesamtdesign reicht dieser Umfang nicht aus.
Was AlphaEvolve am Produktgenerator verändert
Die ausgewählte Variante berechnet die Vielfachen a, 2a und 3a einmal und nutzt sie in vier Lanes. Jede Lane zerlegt ihren zweiten Operanden in vier Radix-4-Ziffern. Die daraus gewählten Teilprodukte q0 bis q3 erfüllen exakt:
p = q0 + 4*q1 + 16*q2 + 64*q3
p[1:0] = q0[1:0]
p[15:2] = (q0 >> 2) + q1 + 4*q2 + 16*q3
Die unteren zwei Produktbits werden direkt weitergereicht. Für die oberen vierzehn Bits ordnet der Kandidat die übrigen Teilproduktbits in vier gepackten Operanden an. Ihre Summe bleibt mathematisch gleich, führt in diesem Syntheselauf aber zu einer günstigeren Verzögerung bei leicht höherer Zellfläche.
Radix-4-Zerlegung und gemeinsame Vielfache sind bekannte Verfahren und bereits in unseren klassischen Vergleichen enthalten. Der hier belegte Beitrag ist die konkret ausgewählte RTL-Anordnung unter dem eingefrorenen Bewertungsverfahren. Eine gesonderte Ablation, die ausschließlich die Bitpackung verändert und alle übrigen Strukturentscheidungen festhält, ist in dieser Kampagne nicht enthalten. Wir schreiben den gemessenen Unterschied deshalb nicht einer unbewiesenen einzelnen Ursache zu.
Was bringt das Werkzeugfeedback?
Für den Feedbackvergleich betrachten wir die ersten acht Vorschläge von A1 und A2 und die acht isolierten Vorschläge. Das Budget enthält in allen drei Gruppen auch Fehlversuche und Duplikate. Der beste neue ADP-Wert beträgt 44.423,4455 für A1, 38.911,1987 für A2 und 44.825,2613 µm²·ns für die isolierte Kontrollgruppe. Wenn die gemeinsame Ausgangslösung erhalten bleibt, liegen A1 und die isolierte Gruppe damit weiterhin bei 39.847,2268 µm²·ns. Nur A2 verbessert sie.
In dieser Beobachtung hilft die rückgekoppelte Suche, einen besseren Kandidaten zu finden. Zwei Suchverläufe und ein Kontrollpool erlauben jedoch keine belastbare Schätzung der Erfolgswahrscheinlichkeit. Außerdem verändern Feedback, Auswahlhistorie und nachfolgende Prompts gemeinsam den Suchverlauf. Aus diesem Versuch lässt sich nicht ableiten, welcher interne Mechanismus des Modells den Ausschlag gegeben hat. Ein garantierter oder allgemein statistisch belegter Vorteil wird nicht behauptet.
Protokollabweichungen bleiben Teil des Ergebnisses
Alle vier Hauptsuchen enden nativ mit COMPLETED. Von den acht Kontrollen beenden sieben diesen Ablauf ebenfalls. Kontrolle 02 wird extern gültig ausgewertet, ihr finaler Score wird wegen der lokalen Kostenkontrolle aber nicht mehr an den nativen Dienst übergeben. Ein begrenzter Finalisierungsversuch ändert das nicht. Der Dienst endet mit PAUSED und ohne finale Scorequittung. Der extern geprüfte Wert bleibt in der wissenschaftlichen Kontrollgruppe enthalten. Er ist nicht der beste Kontrollwert.
Kontrolle 05 scheitert an einem formalen Gegenbeispiel. Sie wird nicht durch einen neuen Versuch ersetzt. A2 benötigt außerdem nach einem lokalen Speicherfehler eine Fortsetzung im selben Experiment. Die fünfzehn bereits erzeugten Vorschläge, ihre Bewertungen und die ursprüngliche Frist bleiben erhalten. Der ausgewählte Vorschlag 8 liegt zeitlich vor diesem Eingriff. Die berichtete Laufzeit enthält die Unterbrechung. Die Kampagne war damit nicht vollständig unbeaufsichtigt.
Kosten und Aufwand: was tatsächlich bilanziert ist
Die zwölf Modellläufe ergeben zusammen eine konservative Planungsschätzung von 53,573994 EUR. Davon entfallen 49,031676 EUR auf die vier Hauptsuchen und 4,542318 EUR auf die acht Kontrollen. Die Rechnung verwendet die dokumentierten Tokenzähler mit den im Versuch angesetzten Listenpreisen von 12 USD je Million Eingabetokens und 60 USD je Million Ausgabetokens. Ein Reservefaktor von 1,5 EUR je USD dient der vorsichtigen Planung und ist kein behaupteter Wechselkurs.
Diese Zahl ist keine geprüfte Rechnung. Sie umfasst weder die Werkzeugrechenzeit noch Vorbereitung, Codex-Abonnement oder manuelle Eingriffe. Die vier Hauptläufe dauern jeweils ungefähr 71 bis 100 Minuten inklusive Generierung und Bewertung. Bereits vorhandene Belege im Cache können einzelne Bewertungen verkürzen. Aus einer solchen Laufzeit lässt sich kein Vergleich mit einem von Grund auf begonnenen, vollständig durchgängig erfassten manuellen Entwurfsprojekt ableiten.
Damit ist eine drastische Verkürzung des gesamten Designprozesses hier nicht nachgewiesen. Dafür müssten mehrere unbekannte Entwurfsaufgaben, ein gleichwertiges Endergebnis und sämtliche Modell-, Werkzeug- und Arbeitsaufwände vorab als gemeinsame Vergleichsbasis festgelegt werden.
Zusatzversuch: Helfen konkrete Fehlerdiagnosen?
Nach Abschluss der vier ursprünglichen Suchen wurde ein zusätzlicher Lauf mit unverändertem Ziel B ausgeführt. Der Prüfer gab nun konkrete, aus den Originalprotokollen gelesene Gegenbeispiele und FMA-Abweichungen zurück. Für rechnerisch korrekte, aber zu langsame oder zu große Vorschläge wurde außerdem ein abgestufter negativer Strafwert eingeführt. Die ursprüngliche Zulässigkeitsgrenze von 2,243918896 ns blieb unverändert.
Dieser Lauf erzeugte 24 neue Vorschläge mit 20 unterschiedlichen Quellständen. 0 Vorschläge erfüllten die ursprünglichen Funktions-, Flächen- und Timingkriterien. Das vorab begrenzte Budget wurde vollständig abgearbeitet. Die klassische Ausgangsschaltung blieb in der Auswahl verfügbar. Ein negativer Strafwert zählt ausdrücklich nicht als zulässiger Hardwareentwurf.
Die Laufzeit ab Suchstart betrug 84.8 Minuten. Die konservative Modellkostenschätzung beträgt 8.78 Euro. Sie verwendet wie der Hauptversuch USD-Listenpreise mit dem Planungsfaktor 1,5 und ist keine Rechnung. Werkzeugkosten und Eingriffe werden getrennt im vollständigen Zusatzpaket dokumentiert.
Textdiagnosen und Strafwert wurden gemeinsam geändert. Eine einzelne zusätzliche Suchtrajektorie trennt ihre Beiträge nicht voneinander. Der Versuch beantwortet, was unter diesen konkreten Bedingungen herauskam. Er liefert keinen statistischen Nachweis dafür, dass eine bestimmte Feedbacktechnik allgemein besser oder schlechter ist.
Das Ergebnis des Zusatzversuchs: Auch das detailliertere Feedback führte in diesem Lauf zu keinem neuen Entwurf innerhalb der festen Timinggrenze. Die Referenz wurde nicht verbessert.
Daten, Quelltexte und Grenzen der Wiederholung
Das vollständige kuratierte Nachweispaket zu dieser Kampagne enthält alle 104 Vorschlagszeilen, 25 klassische Vergleichsentwürfe als Kennwerttabelle, den exakten Rechenvertrag, Tokenzähler, Originalquelltexte der Referenz und des ausgewählten Kandidaten sowie dessen unveränderte Yosys-Flächenstatistik und OpenROAD-Timingausgabe. Die Hashliste bindet die bereitgestellten Dateien an diesen Veröffentlichungsstand.
python verify_alphaevolve.py --self-testDieser Offlineprüfer berechnet die Rangfolge und Prozentwerte neu und kontrolliert acht absichtlich beschädigte Datenvarianten. Er prüft auch eine Python-Rekonstruktion der Produktidentität für alle 65.536 skalaren Eingangspaare. Er führt weder die native Suche noch Synthese, SAT, vollständige FMA-Simulation oder Verdrahtung erneut aus. Diese Trennung verhindert, dass eine erfolgreiche Datenprüfung als neue physische Validierung erscheint.
Der anschließende vollständige Kachelvergleich nach der Verdrahtung ist inzwischen abgeschlossen. Er untersucht den ausgewählten A2-Entwurf gemeinsam mit Balanced und Radix16. Dort bestätigt sich der Synthesevorteil nicht. A2 besteht die Funktionsprüfung, verletzt jedoch eine Fanoutgrenze und erreicht auch in den diagnostischen Timing- und Flächenwerten keinen Vorteil gegenüber der jeweils stärksten klassischen Variante. Diese Folgeprüfung wird mit ihren eigenen physischen Randbedingungen veröffentlicht. Ein Vollmodell-, Energie- oder Marktvorteil ist kein Ergebnis der Suchkampagne.
Konsequenz für den nächsten Entwurf
Der abgeschlossene Layoutvergleich in AR-023 bestätigt den Synthesevorteil nicht. Die klassische Referenz bleibt für die vollständige Kachel maßgeblich.