
Forschungsbericht · veröffentlicht am 10. November 2026
Die Frage hinter dem gemeinsamen Produktgenerator
In einer Matrixoperation wird derselbe Aktivierungswert häufig mit mehreren Gewichten multipliziert. Eine einzelne Lane kann das Produkt selbst berechnen. Alternativ lassen sich ausgewählte Vielfache des gemeinsamen Werts einmal erzeugen und an mehrere Lanes verteilen. Das spart möglicherweise Logik, verlangt aber zusätzliche Auswahl- und Verbindungsstrukturen. Genau dieser Zielkonflikt lässt sich durch einen Operationszähler allein nicht entscheiden.
Unsere Hypothese lautet: Die eingesparte Teilproduktlogik könnte die Fläche verringern, ohne die erreichbare Taktrate wesentlich zu verschlechtern. Der Versuch hält Funktion, Registergrenzen und physischen Rahmen konstant. Er bewertet die tatsächlich entstandene Schaltung nach der Detailverdrahtung. Die relevanten Größen sind Standardzellfläche, Leitungen, elektrische Last und interne Timinggrenze.
Gleiche Rechnung, zwei Implementierungen
Für jede Lane gilt exakt Produkt = x × (128 + fraction). Der gemeinsame Eingang x ist acht Bit breit und nimmt Werte von 0 bis 255 an. Die sieben Gewichtsbruchbits bilden Werte von 0 bis 127 ab. Das vollständige Ergebnis benötigt 16 Bit. Es wird weder vorzeitig gerundet noch abgeschnitten.
Die Referenz erzeugt das Produkt separat für jede Lane. Der Kandidat berechnet gemeinsam nutzbare Vielfache von x. Jede Lane wählt anhand ihrer Gewichtsbits Teilprodukte und setzt daraus ihr eigenes Ergebnis zusammen. Die Gewichte bleiben veränderbare Eingänge. Beide Entwürfe haben registrierte Ein- und Ausgänge. Nach dem Füllen der Pipeline liefern sie je Lane ein Ergebnis pro Takt.
Untersucht werden jeweils 16 und 32 Lanes. Der Vergleich betrifft ausschließlich diesen vorzeichenlosen Signifikanden-Produktpfad. Exponentenbehandlung, NaN und Unendlich, Rundung und FP32-Akkumulation gehören nicht zu den vier Layouts. Ein vollständiger Gleitkomma-FMA ist daher eine eigene Nachweisaufgabe.
Der physische Versuch ist innerhalb jedes Paars gleich
Alle vier Entwürfe wurden mit dem offenen IHP-SG13G2-Prozess und derselben typischen Bibliothek bei 1,20 V und 25 °C verarbeitet. Die Taktperiode beträgt 50 ns, das Ein- und Ausgangsbudget jeweils 10 ns, die Taktunsicherheit 0,1 ns. Ausgangslast, Synthese- und Layoutbedingungen sind innerhalb der Paare identisch. Die feste Die-Größe beträgt 800 × 800 µm bei einem Kern von 760 × 760 µm.
Ein vollständiger Platzierungs- und Verdrahtungslauf je Variante bildet die Datenbasis. Danach wurden die parasitären Leitungswiderstände und -kapazitäten extrahiert. Das ist eine physische Entwurfsanalyse am Computer, keine Messung an einem gefertigten Chip. Mehrere Platzierungsseeds und weitere Prozess-, Spannungs- oder Temperaturecken wurden in diesem Versuch nicht untersucht.
Da die äußere Die-Fläche fest vorgegeben ist, bedeutet eine um 7,61 % kleinere Standardzellfläche nicht einen um 7,61 % kleineren fertigen Chip. Sie bezeichnet die Summe der in der Auswertung erfassten Standardzellflächen.
Die fertigen Netzlisten rechnen die erwarteten Produkte
Die logische Prüfung verwendet die finalen verdrahteten Verilog-Netzlisten, nicht einen stillen Rückfall auf die ursprüngliche RTL-Beschreibung. Jede der vier Varianten wird mit denselben 34.816 gepackten Eingabevektoren getestet. Die ersten 32.768 Vektoren enthalten alle 256 Eingabewerte und 128 Gewichtsbruchwerte. Weitere 2.048 Vektoren prüfen deterministisch erzeugte Kombinationen.
Ein unabhängiger Ganzzahlvergleich prüft insgesamt 3.342.336 einzelne Lane-Ausgaben. Die Testbench berücksichtigt die Registerstufen, lässt anfangs undefinierte Ausgaben unbewertet und leert die Pipeline nach dem letzten Eingabewert. Alle vier Netze bestehen. Eine gezielte Kontrolle mit invertiertem Ausgabebit wird zurückgewiesen.
Dieser Netzlistentest arbeitet ohne Verzögerungen. Seine Laufzeit auf dem Host ist keine Chipzeit. Die funktionale Gleichheit und die nachfolgende statische Timinganalyse sind zwei getrennte Nachweise.
Weniger Zellfläche, mehr Verbindungsaufwand
| Größe | 16 Referenz | 16 gemeinsam | 32 Referenz | 32 gemeinsam |
|---|---|---|---|---|
| Standardzellfläche | 108.739 µm² | 103.023 µm² | 211.797 µm² | 195.683 µm² |
| Verdrahtete Gesamtlänge | 364.106 µm | 578.152 µm | 774.056 µm | 1.172.929 µm |
| Interne Mindestperiode | 5,795 ns | 8,528 ns | 6,732 ns | 9,243 ns |
| STA-Maximalfrequenz | 172,56 MHz | 117,26 MHz | 148,55 MHz | 108,19 MHz |
| Pufferzellen | 1.259 | 1.419 | 2.500 | 2.859 |
| Höchster Signal-Fanout | 8 | 12 | 13 | 14 |
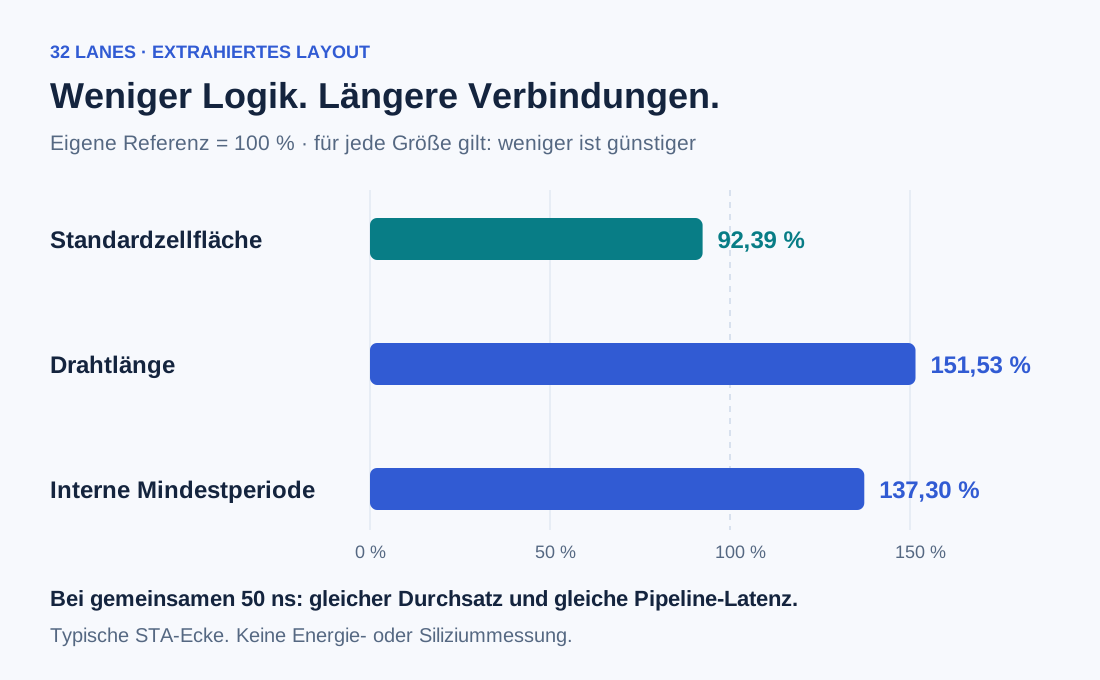
Bei 32 Lanes sinkt die Standardzellfläche von 211.797 auf 195.683 µm². Das entspricht 7,61 % weniger Zellfläche. Gleichzeitig wächst die verdrahtete Länge von 774.056 auf 1.172.929 µm, also um 51,53 %. Bei 16 Lanes treten dieselben Richtungen auf: 5,26 % weniger Zellfläche und 58,79 % mehr Drahtlänge.
Auch die Pufferzahl steigt. Die zusätzlichen Puffer liegen im Signalnetz. Bei 32 Lanes werden dort 2.742 statt 2.383 Puffer gezählt. Die Anzahl der Taktpuffer bleibt innerhalb des Paars unverändert. Der zusätzliche Aufwand lässt sich deshalb nicht einfach einem größeren Taktbaum zuschreiben.
Diese Beobachtung ist mit längeren Wegen für gemeinsam erzeugte Werte vereinbar. Sie beweist noch nicht, dass ein bestimmter Teilproduktbus allein die Verschlechterung verursacht. Dafür müssten gleiche Schaltungen mit gezielt veränderter räumlicher Verteilung verglichen werden.
Warum wir die inneren Registerpfade separat auswerten
Der ursprüngliche Timingbericht wurde durch das feste 10-ns-Ausgangsbudget geprägt. Seine begrenzenden Pfade führen vom Ausgangsregister zum Ausgangsport. Werte von ungefähr 10,8 ns beschreiben unter diesen Bedingungen deshalb nicht die innere Rechengrenze. Eine Rangfolge der Rechenarchitektur daraus wäre irreführend.
Ein gesonderter Readback hat dieselben finalen Layoutdaten und extrahierten Parasitiken erneut eingelesen. Es erfolgte keine neue Synthese, Platzierung oder Optimierung. Alle 16 finalen Dateiidentitäten der vier Entwürfe wurden abgeglichen. Zusätzlich zur internen Mindestperiode wurden die zehn schlechtesten Setup- und Holdpfade jedes Designs explizit zwischen Registern ausgewertet.
Für die vorliegenden gleichflankigen Ein-Takt-Pfade ergibt sich die interne Mindestperiode aus 50 ns − schlechtester interner Setup-Slack. Bei 32 Lanes erhält die Referenz 6,731903 ns, der gemeinsame Generator 9,243183 ns. Der Kandidat verlangt damit eine um 37,30 % längere Periode. Bei 16 Lanes steigt sie von 5,794968 auf 8,528076 ns, entsprechend 47,16 %.
Bei dem tatsächlich festgelegten 50-ns-Takt bleiben Durchsatz und Pipeline-Latenz gleich. Die interne STA bewertet die unterschiedliche Timingreserve. Ihre rechnerischen Maximalfrequenzen sind keine über alle Betriebsbedingungen freigegebenen Siliziumtaktraten. Die genaue Dezimaldarstellung dient der Nachrechnung und beschreibt nicht die Genauigkeit des physikalischen Modells.
Eine begrenzte Timingausnahme und verbleibende Regeln
Die strengen ursprünglichen Timingquittungen wurden nicht nachträglich auf Erfolg umgeschrieben. Sie melden je Design drei Treiber ohne Leitungsannotation. Eine separate Prüfung identifiziert genau diese Pins als unverbundene Ausgänge von Taktbaum-Dummylasten. Die Eingänge der Zellen bleiben mit positiver Library-Kapazität im extrahierten Taktbaum verbunden. Auch ihre Erreichbarkeit im Widerstandsgraph wird geprüft.
Nur diese offenen Ausgänge werden in der anschließenden begrenzten Qualifikation ausgenommen. Angeschlossene Ausgänge, fehlende Eingangsverbindungen oder getrennte Widerstandsverbindungen müssen in gezielten Negativkontrollen scheitern. Resetpins, die das Werkzeug bei der Registerabfrage mitführt, wurden ebenfalls kontrolliert. Sie liegen inaktiv an High. Die berichteten Setup- und Holdpfade enden tatsächlich am Dateneingang der Register.
| Regel | 16 Referenz | 16 gemeinsam | 32 Referenz | 32 gemeinsam |
|---|---|---|---|---|
| Signal-Fanout, Ziel höchstens 8 | 0 | 1 | 2 | 6 |
| Gemeldete Slew-Verletzungen | 0 | 0 | 0 | 0 |
| Gemeldete Kapazitätsverletzungen | 0 | 0 | 0 | 0 |
| Detailroute-DRC / Antennen | 0 / 0 | 0 / 0 | 0 / 0 | 0 / 0 |
Das 50-ns-Setup-/Hold-Ziel ist unter dieser engen Ausnahme erfüllt. Die Tabelle zeigt jedoch verbleibende Fanout-Zielverletzungen. Diese werden durch die Ausnahme nicht aufgehoben. Ein Timingvergleich an einer typischen Ecke ist keine vollständig abgeschlossene elektrische Freigabe, keine unabhängige Foundry-DRC-/LVS-Prüfung und keine Produktionsfreigabe.
Was die Kapazitätsdiagnose über Energie sagen kann
| Netzklasse | 16 Referenz | 16 gemeinsam | 32 Referenz | 32 gemeinsam |
|---|---|---|---|---|
| Signalnetze | 52,5858 pF | 96,3620 pF | 118,7418 pF | 202,8779 pF |
| Taktbaum | 1,2022 pF | 1,0831 pF | 2,2157 pF | 2,1779 pF |
Die Signalnetzsumme steigt bei 32 Lanes von 118,7418 auf 202,8779 pF. Das sind 70,86 % mehr in derselben Auswertedefinition. Zusammen mit Drahtlänge und Pufferzahl ist dies ein konkreter Hinweis auf zusätzliche elektrische Last.
Die Zahl ist die Summe der gemeldeten D_NET-Gesamtkapazitäten. Die Extraktion enthält dabei keine Zell-Pinkapazitäten. Kopplung kann zu mehreren Netzsummen beitragen. Es handelt sich daher weder um eine eindeutig einmal gezählte physische Gesamtkapazität noch um die tatsächlich geschaltete Kapazität.
Für Energie fehlen Aktivitätsverteilung, Zellleistungsmodelle im betrachteten Arbeitsfall und eine gemeinsame vollständige Bilanzgrenze. Aus der kleineren Fläche folgt kein Energiegewinn. Aus der höheren Kapazität allein folgt umgekehrt noch keine vollständige negative Energiebilanz. Dieser Versuch liefert keine Energiezahl.
Die nächste Hypothese richtet sich nach den gemessenen Pfaden
Die globale Teilproduktverteilung gewinnt hier die Zellflächenrangfolge und verliert die Rangfolge bei interner Mindestperiode, Drahtlänge und Pufferzahl. Damit ist die geprüfte Ausführung für ein vorrangiges Geschwindigkeitsziel kein Gewinner. Der Befund gibt eine konkrete Auswahlentscheidung und nicht bloß einen offenen Wunsch vor.
Als nächste Änderung kommen kleinere benachbarte Sharing-Gruppen in Betracht. Sie könnten Verteilungswege verkürzen, benötigen aber erneut zusätzliche Tabellenlogik. Daneben müssen die lane-lokale Auswahl und Addition untersucht werden. Lange kapazitive Netze können auch nach der gemeinsamen Verteilung entstehen. Eine bloße Verringerung des ersten Broadcast-Fanouts wäre deshalb noch keine vollständige Lösung.
Ein sauberer Folgeversuch hält die gesamte Lanezahl und die Arithmetik fest und ändert jeweils nur die Gruppierung oder die lokale Implementierung. Ein vollständiges 16-Lane-Array ist keine kontrollierte Ablation eines 32-Lane-Arrays mit zwei Sharing-Gruppen. Neue Kandidaten werden erst nach denselben Funktionstests und physischen Prüfungen eingeordnet.
Daten, Rechenweg und Nachvollziehbarkeit
Die Daten- und RTL-Veröffentlichung enthält unveränderte JSON-Auswertungen, ausgewählte Schaltungsquellen, Prüfsummen und einen ausführbaren Offlineprüfer. Die Produktvergleichsdaten und KI-Vergleichsdaten sind auch einzeln verfügbar. Der Prüfer kontrolliert die Rechnung und die Bindung an die mitgelieferten Quellen. Er startet keinen neuen physischen Entwurf.
Die veröffentlichten Quellen unterscheiden die ursprüngliche strenge Timingbewertung von der anschließend begründet qualifizierten Auswertung. Hashes verbinden den Readback mit den identischen Ausgangslayouts. Die nativen Layoutarchive und eine erneute Foundry-Prüfung sind nicht Teil des Downloads. Die Ergebnisse gelten für diesen Baustein unter den genannten Bedingungen. Sie ersetzen keinen Vollmodell- oder Marktvergleich.
Konsequenz für den nächsten Entwurf
Globale Teilproduktverteilung nicht als Geschwindigkeitsgewinner weiterführen. Lokale Auswahl und Addition sowie räumlich begrenzte Wiederverwendung getrennt untersuchen. Die geringere Zellfläche bleibt ein dokumentierter Nutzen mit konkreten Verbindungskosten.