
Forschungsbericht · veröffentlicht am 10. November 2026
Die Alternative zur KI muss dieselbe Aufgabe gut lösen
Ein einfacher Zufallsvorschlag oder eine schwache Reparaturregel würde die Frage zu leicht machen. Für bekannte, klar beschreibbare Modulklassen gibt es eine stärkere klassische Alternative: Ein Generator kann aus Schnittstelle und Verhaltensvertrag unmittelbar eine korrekte Schaltung erzeugen. Er benötigt für jede neue Parameterkombination keine Modellanfrage.
Wir vergleichen deshalb einen solchen deterministischen Vertragsgenerator mit Gemini 3.8 Flash und Gemini 4 Argon. Beide Modelle wurden über Vertex AI tatsächlich aufgerufen. Die Modellkennungen stammen aus den archivierten Antworten. Es handelt sich nicht um einen Vergleich mit dem Codex-Assistenten, der am Projekt arbeitet.
Die Forschungsfrage ist eng: Bringt ein LLM bei bereits bekannten kleinen Modulklassen mehr korrekt gelöste Aufgaben oder weniger Onlineaufwand als der vorhandene Generator? Der Versuch bewertet keine neue Gesamtarchitektur und keine allgemeine Fähigkeit, Produktionschips zu entwickeln.
Sechs neue Instanzen aus drei bekannten Familien
Jede Instanz beginnt mit einem synthetisch eingefügten Fehler. Der Vertrag, die Parameter und der fehlerhafte Quelltext werden vor der Modellanfrage festgelegt. Modelle und Generator dürfen vollständige Ersatzmodule liefern. Eine künstliche Beschränkung auf die Reparatur genau einer Zeile gibt es nicht.
| Familie | Zwei Instanzen | Verbindliche Funktion |
|---|---|---|
| Exakte Produkte | 4 beziehungsweise 7 Lanes | 8-Bit-Eingang × (128 + 7-Bit-Bruchwert), vollständiges 16-Bit-Ergebnis |
| Lokale Summenkontexte | 2 × 24 Bit beziehungsweise 4 × 32 Bit | Modulare Ganzzahlsummen mit Enable, Clear, Reset und festgelegtem Überlauf |
| Weitergabepuffer | 13 beziehungsweise 29 Bit | Ein Speicherplatz, Ready/Valid, Rückstau und gleichzeitige Annahme/Ausgabe ohne Blase |
Die Summenkontexte sind ausdrücklich Ganzzahlschaltungen. Ihr Bestehen ist kein Nachweis einer FP32-FMA. Die Familien sind dem Experimentautor bekannt und wurden von ihm konstruiert. Neue Parameter und Fehler machen daraus keine verdeckten realen Kundenprojekte. Auch eine Überschneidung der allgemeinen Aufgabenideen mit Modelltrainingsdaten lässt sich nicht ausschließen.
Entwicklungsdiagnose als kontrollierte Zusatzinformation
Für jedes Modell gibt es zwei Bedingungen. Die erste enthält Vertrag und fehlerhafte Quelle. Die zweite enthält zusätzlich die erste Fehlermeldung einer Entwicklungsprüfung und bis zu sieben zugehörige Eingabezeilen. Außer diesem Diagnoseblock bleiben die Eingabepakete gleich. Die zusätzlichen verdeckten Prüfsequenzen werden nicht an die Modelle übertragen.
Jede Bedingung läuft zweimal in getrennten, zustandslosen Anfragen. Die Reihenfolge der Bedingungen wird in der zweiten Wiederholung umgekehrt. Temperatur und Thinking-Einstellung werden konstant gehalten. Jede Antwort enthält einen Kandidaten für jede der sechs Aufgaben. Es gibt weder eine nachträgliche Auswahl des besten Vorschlags noch eine manuelle RTL-Reparatur nach dem Einfrieren.
Der Diagnosearm erhält Entwicklungsfeedback bereits im Prompt. Dies ist keine mehrstufige autonome Agentenschleife. Der Vergleich misst deshalb den Nutzen dieser konkreten Zusatzinformation und nicht jede mögliche Form werkzeuggestützter KI.
Gleicher Compiler, gleiche Testfolgen, unabhängige Erwartungswerte
Ein separat programmierter Python-Oracle berechnet die erwarteten Ausgaben. Der Generator verwendet diese Ausgaben nicht zur Schaltungserzeugung. Alle Vorschläge durchlaufen dieselben Quellverbotsprüfungen, denselben Icarus-Compiler und dieselben unveränderten Testdateien. Pro Kandidat sind höchstens eine Kompilierung und drei Simulationen vorgesehen. Beim ersten fachlichen Fehler würde die Bewertung dieses Kandidaten abbrechen.
Für die Produktaufgaben enthält die Entwicklungsfolge alle 32.768 Eingang/Bruchwert-Paare. Zwei weitere getrennte Zufallsfolgen enthalten jeweils 8.192 Zeilen. Die Kontext- und Pufferfälle verwenden jeweils drei Folgen mit 4.096 Zeilen. Zusätzliche Kontrollen bestätigen, dass der Referenzgenerator alle Fälle besteht und jeder der sechs ursprünglichen Fehler erkannt wird.
Ein vollständiger Arm verarbeitet 147.456 Trace-Zeilen. Über zehn Arme sind das 1.474.560 Vergleiche und 240 Compiler-/Simulatoraufrufe. Eine Zeile kann mehrere Lanes oder Kontextzustände enthalten. Sie ist keine unabhängige Forschungsaufgabe. Der Umfang bleibt sechs Fälle aus drei Familien.
Alle Verfahren bestehen, der Generator benötigt weniger Onlinezeit
| Verfahren | Wiederholung 1 | Wiederholung 2 | Median |
|---|---|---|---|
| Vertragsgenerator | 8,62 s | 7,97 s | 8,29 s |
| Gemini 3.8 Flash · ohne Diagnose | 12,16 s | 12,08 s | 12,12 s |
| Gemini 3.8 Flash · mit Diagnose | 12,02 s | 12,94 s | 12,48 s |
| Gemini 4 Argon · ohne Diagnose | 45,76 s | 41,11 s | 43,44 s |
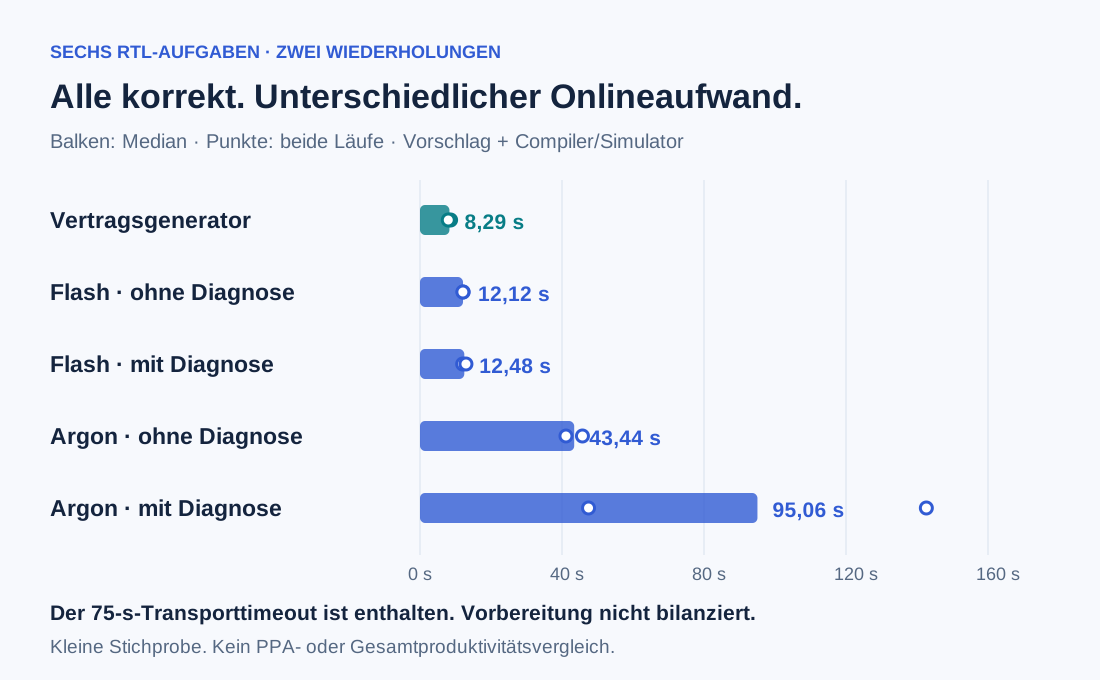
| Gemini 4 Argon · mit Diagnose | 142,64 s | 47,48 s | 95,06 s |
Alle fünf Verfahren lösen in jeder Wiederholung sämtliche sechs Aufgaben. Die beobachtete Erfolgsquote beträgt überall 6/6. Zusätzliche Entwicklungsdiagnose erhöht sie hier nicht, weil schon die Bedingung ohne Diagnose alle Aufgaben besteht. Der Versuch hat bei diesem Funktionsmaß einen Deckeneffekt.
Gemessen wird die Summe aus Vorschlagserzeugung und den anschließend tatsächlich ausgeführten Compiler- und Simulatorläufen eines vollständigen Arms. Die Tabelle zeigt beide Beobachtungen und ihren Median. Bei zwei Werten ist dieser Median deren arithmetische Mitte. Er ist kein Konfidenzintervall und keine stabile Schätzung über eine breite Aufgabenverteilung.
Der Vertragsgenerator erreicht einen Median von 8,29 s. Flash benötigt rund 12 s, Argon in diesen Aufrufen rund 43 s ohne und 95 s mit Diagnose. Die Aussage ist eine Online-Rangfolge bei gleich bestandener Funktion. Unterschiedliche akzeptierte RTL-Quellen können trotzdem unterschiedliche Fläche, Timing und Energie besitzen. Solche PPA-Größen wurden hier nicht bewertet.
Der Timeout gehört zum Ergebnis und nicht in den Papierkorb
Ein erster Argon-Aufruf mit Diagnose erreichte die anfänglich konfigurierte Transportgrenze von 75 Sekunden. Der Versuch ist erhalten und seine verstrichene Zeit wird dem Arm zugerechnet. Vor der fachlichen Auswertung wurde für alle Arme einheitlich höchstens eine identische Wiederholung bei Transporttimeout zugelassen. Die neue Transportgrenze beträgt 600 Sekunden. Der identische Retry gelang.
So ergibt sich für den betroffenen Arm einschließlich Werkzeugen eine Dauer von 142,64 s. Die zweite Wiederholung derselben Bedingung benötigt 47,48 s. Aus diesem Unterschied kann nicht gefolgert werden, dass Diagnose Argon grundsätzlich verlangsamt. Stichprobe, Netzwerklatenz und Transportstörung reichen nicht aus, um einen solchen Kausaleffekt zu bestimmen.
Insgesamt wurden neun Generierungsversuche für acht vollständige Modellantworten protokolliert. Es gab keine inhaltliche Nachbesserung anhand der zurückgehaltenen Tests. Neben 240 bewerteten Werkzeugaufrufen fallen 36 gemeinsame Kontrollaufrufe und vier Tokenzählaufrufe an.
Was Zeit und Kosten umfassen und was nicht
Die Onlinezeit beginnt erst im eingerichteten Experiment. Die Erstellung des Vertragsgenerators, der Aufgaben, des Oracles und der Prüfumgebung war Entwicklungsarbeit. Sie wurde nicht als aktive Personen- oder Codex-Arbeitszeit separat gemessen und ist nicht kostenlos. Auch proprietäres Modelltraining, Codex-Abonnement beziehungsweise Tokenzuordnung und lokale elektrische Energie fehlen in der Kostenbilanz.
Die belegbare Kalenderzeit zwischen Beginn der eingefrorenen Kontrollen und Abschluss der Bewertung beträgt 580,40 s. Sie enthält Warten, Koordination, Transportkorrektur und Auswertung. Sie ist keine aktive Arbeitszeit. Der lokale Windows-Host war nicht exklusiv reserviert. Die gemessenen Werkzeugzeiten sind deshalb keine präzisen plattformunabhängigen Benchmarks.
Bekannte Modellkosten betragen nach der archivierten konservativen Listenrechnung 0,40963065 USD. Für den Timeout ohne Verbrauchsantwort werden zusätzlich höchstens 0,20944440 USD reserviert. Die Summe von höchstens 0,61907505 USD ist eine Kostenmodellgrenze, keine eingesehene Rechnung und kein vollständiger Projektpreis. Ein API-Kostenwert von null für den Generator bedeutet ausschließlich, dass er keine Modell-API aufruft.
Vier operative Eingriffe sind dokumentiert: vorhandene Anmeldung außerhalb der Sandbox verwenden, Transportgrenze ändern, einheitlichen Timeout-Retry festlegen und eine Importnamenskollision im Fortsetzungsprogramm beheben. Eine zusätzliche Nachverarbeitungskorrektur behandelt LF-/CRLF-Zeilenenden bei Quellhashes. Keine dieser Maßnahmen veränderte einen fachlich bewerteten RTL-Vorschlag.
Welche Rolle die KI daraus in unserer Software erhält
Für diese bekannten Modulklassen ist der vorhandene Generator die sinnvollere Standardausführung. Er liefert denselben getesteten Funktionsumfang bei geringerer beobachteter Onlinezeit. Das Ergebnis ist weder eine allgemeine Widerlegung von KI im Chipdesign noch ein positiver Nachweis umfassender Designproduktivität.
Der nächste aussagekräftige Vergleich muss Aufgaben enthalten, für die der vorhandene Generator noch keine Lösungsschablone besitzt. Dafür braucht es vorab zurückgehaltene Familien, realistische Änderungsaufträge und eine vollständige Erfassung der Entwicklungskosten beider Wege. Wenn das Ziel bessere physische Entwürfe ist, müssen beide Verfahren anschließend dieselben Kriterien für Fläche, Timing und Energie erreichen.
KI-Vorschläge, Generatoren und klassische Suchverfahren sollten nach der Aufgabe ausgewählt werden. TPE oder Bayes-Optimierung können numerische Entwurfsparameter durchsuchen. Für die hier untersuchte reine Reparatur eines vollständig spezifizierten RTL-Verhaltens wären sie keine automatisch stärkere Vergleichsgruppe. Die unabhängige Funktionsprüfung bleibt bei allen Verfahren verbindlich.
Die ausgeführten Vorschläge sind öffentlich nachspielbar
Die Daten- und RTL-Veröffentlichung enthält unveränderte JSON-Auswertungen, ausgewählte Schaltungsquellen, Prüfsummen und einen ausführbaren Offlineprüfer. Die Produktvergleichsdaten und KI-Vergleichsdaten sind auch einzeln verfügbar. Der Prüfer kontrolliert die Rechnung und die Bindung an die mitgelieferten Quellen. Er startet keinen neuen physischen Entwurf.
Das Paket enthält alle 60 tatsächlich kompilierten Kandidaten sowie Verträge, Testbenches und die eingefrorenen Testvektoren. Mit einer vorhandenen Icarus-Verilog-Installation kann ein einzelner vollständiger Arm lokal erneut simuliert werden. Der Paketprüfer benötigt nur Python. Ein lokaler Replay erzeugt keine neue Modellantwort und rekonstruiert nicht die damalige Netzwerklatenz.
Mit der Veröffentlichung sind die ursprünglich zurückgehaltenen Testfolgen öffentlich. Sie dürfen in späteren Experimenten nicht erneut als unbekannte Testfälle ausgegeben werden. Die Originalhashes, die vollständig mitgezählten Fehlversuche und die klar benannten Bilanzlücken machen die Reichweite des Befunds prüfbar.
Konsequenz für den nächsten Entwurf
Bekannte Modulklassen durch den geprüften Vertragsgenerator abdecken. KI anschließend an zurückgehaltenen neuen Aufgabenfamilien messen und Erstellung, Werkzeugläufe und Eingriffe vollständig erfassen. Ein Vorteil im gesamten Chipentwurf ist durch diesen Versuch nicht belegt.