Forschungsbericht · überarbeitet am 09. November 2026
Zwei Datenströme müssen gleichzeitig günstig bleiben
Eine dichte MLP-Rechnung muss Gewichte und laufende Summen bereitstellen. Ein Gewicht kann für viele Tokens wiederverwendet werden. Werden sämtliche Tokenkontexte jedoch im SRAM gehalten, benötigt die modellierte Akkumulation sehr viele lokale Lese- und Schreibzugriffe. Vollständig in Registern bearbeitete kleine Tokenkacheln vermeiden diese Zugriffe, müssen dafür womöglich Gewichte erneut laden.
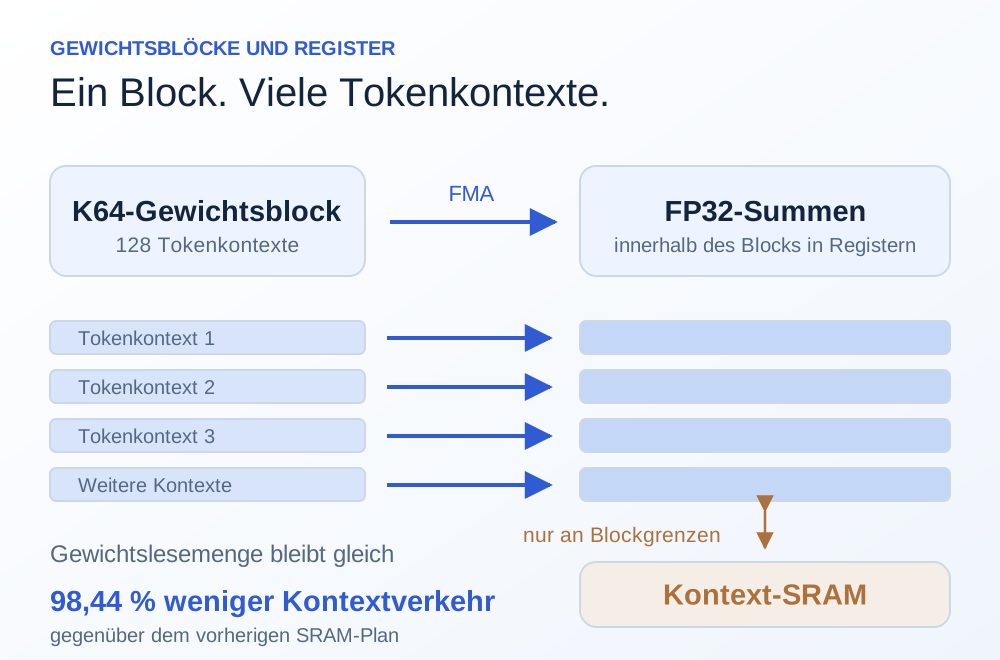
Untersucht wird deshalb ein K64/T128-Plan. Ein Gewichtsblock aus 64 Summenschritten bleibt im Cache, während 128 Tokenkontexte nacheinander rechnen. Innerhalb des Blocks bleiben die FP32-Summen in Registern. Erst an Blockgrenzen werden sie exakt gespeichert oder wiederhergestellt. Diese Anordnung bewahrt die Gewichtsreihenfolge und vermeidet zusätzliche äußere Gewichtsladungen im gewählten Vergleich.
Ein definierter MLP und mehrere ausführbare Pläne
Die Form lautet D = 5.120, H = 17.408 und O = 5.120. Gate und up werden über SiLU und ein BF16-Produkt mit down verbunden. Eingaben und Gewichte sind BF16, die fortlaufende FMA-Summe ist FP32. Die Reduktionsreihenfolge über K bleibt aufsteigend. FP32-Speicherung an Blockgrenzen führt keine zusätzliche Rundung ein.
Eine Python-Integer-FMA bildet die unabhängige Referenz. Ein ohne Fast-Math kompiliertes C++-Modell verwendet std::fma. Sechzehn Zahlenwertfälle werden mit dreizehn Plänen ausgeführt. Insgesamt stimmen 1.391.780 geprüfte Werte und 2.288 Verkehrsgrößen in 208 Ausführungen ohne Abweichung überein. Darunter sind ungerade Formen, Restblöcke und 65, 129 beziehungsweise 257 Tokens. Ein Fall verwendet sechs archivierte echte Gate-Zeilen, die übrigen Gewichte sind überwiegend synthetisch.
Diese Zählung umfasst wiederholte Werte in verschiedenen Plänen. Sie bezeichnet keine entsprechende Zahl unabhängiger Modelllasten. Ausnahmeflags und vollständige Qwen-Antwortqualität werden in diesem Versuch nicht geprüft.
Die Mengenbilanz des Gewichtsblocks
| M256-Plan | Äußere Gewichte | Akkumulator-SRAM | Akkumulatorregister |
|---|---|---|---|
| SRAM-Referenz | 0,535 GB | 547,649 GB | keine zusätzlichen Kontextregister |
| Dauerhaft T32 | 4,278 GB | 0 | 1,875 MiB |
| Dauerhaft T128 | 1,070 GB | 0 | 7,5 MiB |
| K64/T128 | 0,535 GB | 8,556 GB | 2,5 MiB |
Der ausgewählte Plan reduziert den logischen Akkumulator-SRAM-Verkehr um 98,44 %. Die äußeren Gewichtsbytes bleiben exakt 534.773.760 je MLP. Die großen GB-Zahlen sind über den Auftrag kumulierte Zugriffe und keine benötigte Speicherkapazität. Die kleine bestehende RTL-Kachel hält eine einzelne Summe bereits in Registern. Die 98,44 % beziehen sich auf die vorherige SRAM-Abbildung vieler Kontexte und nicht auf einen zusätzlichen Vorteil gegenüber dieser Kachel oder einer GPU.
Unter welchen Portbedingungen entsteht ein Zeitgewinn?
Das Zeitmodell verwendet 160 Module mit je zwei Engines, 16 Ausgabe- und 32 Tokenlanes. Zusammen sind das 163.840 angenommene MAC-Einheiten. Die Frequenz von 1 GHz ist eine Annahme. Gewichte, Eingaben, Rechnen und Kontextwechsel werden in expliziten Phasen bilanziert. Es gibt weder kostenloses Vorladen noch unbegrenzte Puffer. Gate, up und down teilen dieselben Rechenwerke.
Bei M = 256, einem 64-GB/s-Link und 512 Byte Akkumulator-SRAM-Zugriff pro Modul und Zyklus sinkt die modellierte Zeit von 8,164 auf 2,325 ms. Dieser bedingte Vorteil von 71,53 % ist eine Aussage über die knappe SRAM-Abbildung. Bei 8.192 Byte pro Zyklus benötigt die Referenz 2,201 ms und der Kontextplan 2,225 ms. Er ist dann 1,11 % langsamer. Für M = 1 benötigt er rund 0,50 % mehr Zeit. Die Portbreite entscheidet also wesentlich über die Rangfolge.
Kapazität und dynamische Energie verschwinden nicht
K64/T128 benötigt zusätzlich zu 2,5 MiB Akkumulatorregistern insgesamt 15 MiB FP32-Kontext-SRAM. Gewichtscache, replizierte Eingabepuffer, lokale Zwischenwerte, globale Ein- und Ausgaben, Antwort-FIFOs und SiLU-Tabellen bleiben erhalten. Eine gemeinsame obere Referenz für FMA-Pipelineregister führt zu 51,25 MiB gezähltem Payload und Bitzustand. Tags, ECC, Taktverteilung und konkrete Bankinglogik sind darin noch nicht physisch ausgelegt.
Der Plan führt weiterhin etwa 547,608 GB laufende Registerzugriffe aus. Der Speicherort ändert sich, die Summenaktualisierung nicht. Bei gleicher äußerer Gewichtsmenge muss ein Registerbyte einschließlich der erfassten Transfers weniger als ungefähr 96,93 % der Energie eines SRAM-Bytes benötigen, damit der dynamische Tausch günstiger wird. Zusätzliche Leck- und Taktenergie fehlt in dieser Bedingung. Eine Koeffizientensensitivität mit 27 Kombinationen ergibt günstige und ungünstige Fälle, keine Erfolgswahrscheinlichkeit.
Von einer Verkehrsersparnis zur physischen Prüfung
Die C++-Ausführungen und unabhängigen Zähler zeigen, dass die geplante Gewichts- und Kontextbewegung funktional konsistent ist. Die Laufzeiten des C++-Programms selbst sind keine Chipzeiten. Auch die angenommene große Rechengeometrie, ihre Ports und ihre Frequenz sind nicht durch diesen Versuch realisiert.
Der Befund begründet einen engen Folgeschritt: vier lokale Kontexte je Lane im bestehenden RTL mit tatsächlicher Auswahl, Taktlast und Speicheranschlüssen vergleichen. Genau diese Frage untersuchen die separaten Berichte zu vier Kontexten und zur aktiven Summe. Ihre Layout- und Aktivitätswerte ergänzen die hier gemessenen Mengen. Dadurch bleibt die große Verkehrsersparnis überprüfbar, ohne sie vorzeitig in einen unbelegten Gesamtenergiegewinn umzudeuten.
Konsequenz für den nächsten Entwurf
Die nachgerechnete Verkehrsreduktion und ihre Portbedingungen als Grundlage der anschließenden physischen Kontextvergleiche sichern.