Forschungsbericht · überarbeitet am 09. November 2026
Zwei unterschiedliche Rechenverträge
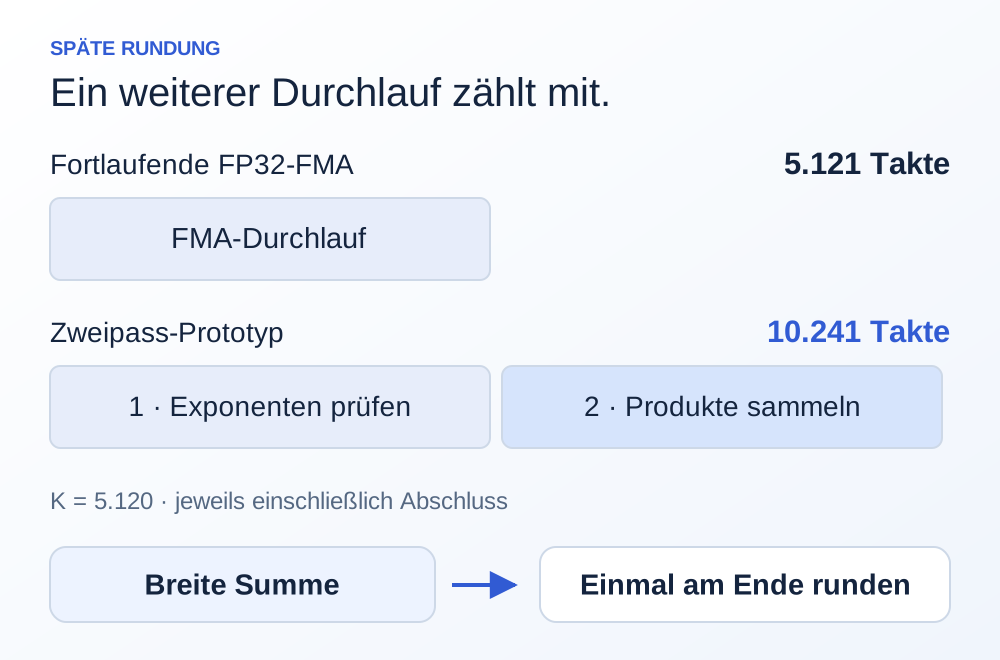
Die bestehende Referenz multipliziert BF16-Operanden und führt die Summe mit aufeinanderfolgenden FP32-FMA-Schritten fort. Jeder Schritt rundet sein Ergebnis auf FP32. Der Kandidat richtet die Produkte als ganze Zahlen an einem gemeinsamen Exponenten aus, sammelt sie breit und rundet erst am Ende einmal auf FP32. Damit ändert sich die Rundungsreihenfolge.
Die Forschungsfrage lautet, ob der reduzierte Rundungsaufwand einen günstigeren vollständigen Rechenpfad ermöglicht. Eine mathematisch genauere Summe ist dabei nicht automatisch identisch mit der sequentiellen Referenz. Für einen Einsatz im Modell wären sowohl die physische Effizienz als auch die numerische Verträglichkeit zu prüfen. Bekannte Exact-dot- und Kulisch-Verfahren bilden den fachlichen Hintergrund, keine hier beanspruchte neue Erfindung.
Der numerische Vorfilter bestimmt die nötige Breite
Der erste Versuch umfasst 192 Skalarprodukte mit K = 5.120. Sechs vollständige Zeilen der archivierten Qwen-Gewichtsstichprobe werden mit 32 synthetischen Eingabevektoren kombiniert. Eine unabhängige Rechnung mit rationalen Zahlen kontrolliert die exakten Summen. Die konservative Breitenprüfung berücksichtigt Exponentabstand, Signifikanden und Summandenanzahl ohne Gutschrift für eine mögliche Auslöschung.
Bei normalverteilten Eingaben werden 56 bis 65 Bit benötigt, bei einzelnen Ausreißern 65 bis 71 Bit und bei weit gespreizten Exponenten 109 bis 117 Bit. Der pauschale 64-Bit-Kandidat lässt deshalb nur 93 von 192 Fällen zu. Eine Ablehnung bedeutet, dass die gewählte Schranke keine sichere Breite garantiert. Sie beweist nicht für jeden Einzelfall einen tatsächlich eingetretenen Überlauf.
Numerische Genauigkeit und Modellidentität auseinanderhalten
181 der 192 FP32-Ergebnisse unterscheiden sich von der sequentiellen FMA-Rechnung. Nach dem abschließenden Cast auf BF16 stimmen die Ergebnisse in allen 192 Stichproben überein. Daraus folgt jedoch keine allgemeine Gleichheit. Der gezielte Auslöschungsfall 2²⁴ + 1 − 2²⁴ ergibt bei exakter Summation 1, bei sequentieller FP32-Rundung 0. Auch nach einem BF16-Cast bleibt dieser Unterschied bestehen.
Die Stichprobe zeigt damit zwei Dinge. Viele kleine FP32-Abweichungen verschwinden beim gröberen Ausgabeformat, andere können erhalten bleiben. Eine spätere Modellprüfung müsste reale Aktivierungen, seltene Exponentenlagen und vollständige Ausgaben einbeziehen. Aus der Reduktion von 5.120 Rundungen auf eine lässt sich insbesondere kein entsprechend großer Geschwindigkeitsfaktor ableiten.
Was die vollständigen RTL-Kerne enthalten
Die beiden Prototypen verwenden 72 beziehungsweise 128 Bit. Ihr erster Durchlauf scannt die Exponenten und prüft die erforderliche Breite. Im zweiten Durchlauf werden dieselben Eingaben erneut gelesen, multipliziert, ausgerichtet und addiert. Hinzu kommen Überlaufkontrolle sowie normale und subnormale Abschlussrundung nach Round-to-nearest-even. NaN und Unendlich gehören nicht zum endlichen Kandidatenvertrag.
Bei K = 5.120 zählt die Simulation 10.241 Kerntakte gegenüber 5.121 für die sequentielle Referenz. Bei gleichem Takt verdoppelt sich die Kernlaufzeit damit nahezu. Eine physische Taktverbesserung müsste diesen Aufwand erst kompensieren. Ablehnungen sind explizit gekennzeichnet, ein produktiver Ausweichpfad ist noch nicht implementiert. Dessen Zeit, Speicherzugriffe und Steuerung dürften bei einer Systembewertung nicht fehlen.
Synthese und Funktion liefern einen klaren Auswahlgrund
Unter derselben Yosys-/ABC-Abbildung in die IHP-Bibliothek ergeben sich summierte Standardzellflächen von 38.581,40 µm² für die Referenz, 73.071,33 µm² für 72 Bit und 96.034,38 µm² für 128 Bit. Das entspricht etwa dem 1,89- beziehungsweise 2,49-Fachen der Referenz. Es sind unplatzierte Zellensummen, keine fertigen Chipflächen. Ein erreichbarer physischer Takt und die dynamische Gesamtenergie wurden nicht bestimmt.
Je Kern wurden 28 RTL-Aufgaben einschließlich sechs langer Skalarprodukte geprüft. Die Referenz liefert 28 Ergebnisse. Die 72-Bit-Variante liefert 24 Ergebnisse und vier korrekte Ablehnungen, die 128-Bit-Variante 26 Ergebnisse und zwei korrekte Ablehnungen. Nach Synthese bestehen jeweils 22 kurze Netzlistenfälle. Die begrenzte lange Netzlistenprüfung läuft ins Zeitlimit und wird nicht als bestanden gewertet.
Welche Änderung einen neuen Versuch rechtfertigen würde
Die beiden geprüften Zweipass-Prototypen werden nicht zur Layoutvertiefung priorisiert. Mehr Zellfläche und nahezu doppelte Taktenzahl liefern in ihrer aktuellen Form keinen günstigen Ausgangspunkt. Das betrifft diese Implementierungen. Breite Integer-Buchführung und der vorgeschaltete Scan lassen Optimierungsmöglichkeiten erkennen, deren Wirkung aber erst ein neuer Vergleich zeigen könnte.
Ein aussichtsreicher neuer Kandidat müsste beispielsweise wiederverwendbare Exponentenmetadaten, schmalere Kontrollfelder oder einen vollständigen effizienteren Fused-dot-Pfad konkret umsetzen. Er wäre gegen eine starke arithmetische Referenz zu prüfen, nicht nur gegen den ersten Prototyp. Unverzichtbar bleiben ein sicherer Zahlenvertrag, ein bezifferter Ausweichpfad und eine Qualitätsprüfung im Modell. Erst dann wäre weniger Rundung ein belastbares Architekturargument.
Konsequenz für den nächsten Entwurf
Die beiden Zweipass-Prototypen nicht ins Layout übernehmen.