Forschungsbericht · überarbeitet am 09. November 2026
Speicher sparen, ohne die Gewichte zu quantisieren
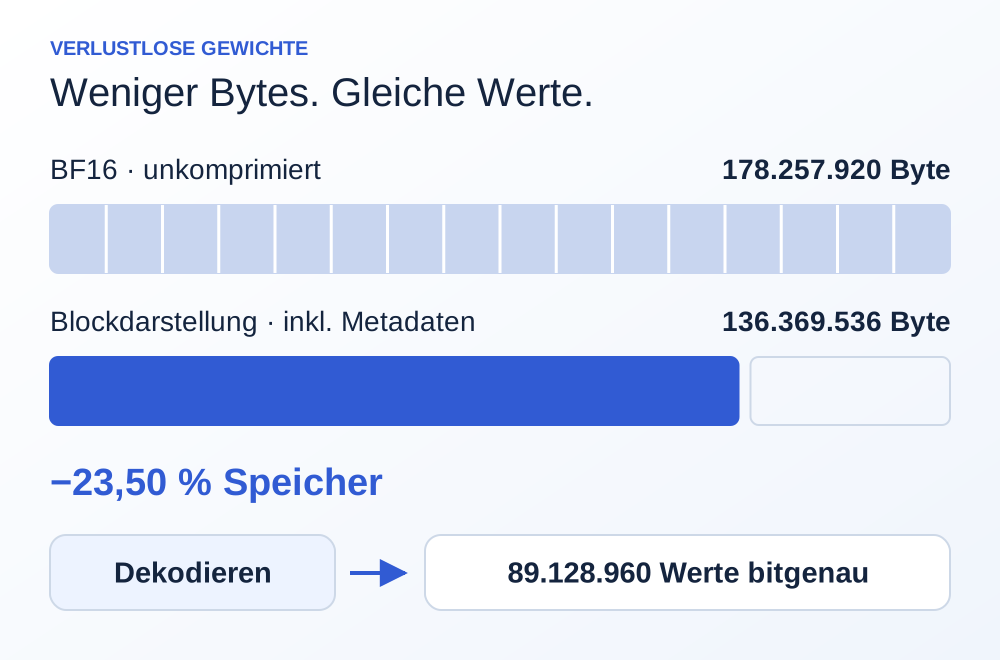
Die untersuchte Matrix ist die Gate-Projektion der ersten MLP-Schicht aus dem gepinnten Qwen-Checkpoint. Sie enthält 17.408 mal 5.120 BF16-Werte. Das sind 89.128.960 Werte und unkomprimiert 178.257.920 Byte. Der Versuch verwendet diese vollständige reale Matrix, keine künstlich besonders gut komprimierbaren Koeffizienten.
Die Hypothese ist einfach: Wenn weniger Gewichtsbytes aus dem Speicher gelesen werden müssen, könnte eine bandbreitenbegrenzte Projektion schneller und energieärmer werden. Anders als bei verlustbehafteter Quantisierung soll jeder BF16-Wert bitgenau rekonstruierbar bleiben. Dafür müssen jedoch Nutzdaten, Metadaten und Dekodierarbeit vollständig in die Vergleichsgrenze aufgenommen werden. Eine kleinere Datei allein beantwortet die Geschwindigkeitsfrage nicht.
Das Blockformat nutzt gemeinsame Exponentenbereiche
Je 256 Werte bilden einen Block. Wenn dessen Exponentenspanne höchstens 15 beträgt, genügt für jeden Exponenten ein 4-Bit-Abstand zum gemeinsamen Bezug. Vorzeichen und Mantisse bleiben unverändert. Ein ungeeigneter Block fällt auf die ursprüngliche 16-Bit-Darstellung zurück. Damit erhält die Darstellung einen klar definierten Ausreißerpfad und muss problematische Werte nicht nachträglich verändern.
Die vollständige GPU-Darstellung zählt zwei Byte Blockheader und vier Byte Offset je Block mit. Von 348.160 Blöcken lassen sich 343.573 komprimieren. Die gemischten Nutzdaten belegen 134.280.576 Byte, Header und Offsets weitere 2.088.960 Byte. Insgesamt entstehen 136.369.536 Byte oder durchschnittlich 12,2402 Bit pro Gewicht. Wenige feste globale Containerfelder sind in dieser GPU-Darstellung nicht enthalten.
Was die Bitprüfung beweist
Alle 89.128.960 BF16-Bitmuster werden nach dem Packen exakt wiederhergestellt. Damit sind die gespeicherten Werte unverändert und der Gewichtsspeicher sinkt um 23,50 %. Diese Aussage benötigt keine angenommene Toleranz für einen Quantisierungsfehler. Die Vollständigkeit der Prüfung ist wichtig, weil eine Stichprobe seltene Rückfallblöcke oder fehlerhafte Offsets übersehen könnte.
Die anschließenden Matrixrechnungen werden gegen FP32 mit denselben BF16-Eingangswerten geprüft. Zugelassene Unterschiede durch die Summationsreihenfolge sind im Versuchsvertrag getrennt festgelegt. Der Test belegt keine ganze Sprachmodellantwort. Er trennt die verlustlose Speicherung von der numerischen und zeitlichen Ausführung des Operators.
Ein GPU-Vergleich mit passenden Kontrollen
Die Messung läuft auf einer RTX PRO 6000 Blackwell Server Edition mit PyTorch 2.8.0 und Triton 3.4. Untersucht werden Batch 1 und Batch 8, jeweils mit drei Eingabeseeds. Die Konfigurationen wurden zuvor auf getrennten synthetischen Gewichten eingestellt und danach auf der echten Matrix festgehalten. CUDA-Graph-Blöcke reduzieren den Einfluss wiederholter Hoststarts.
Neben Wiederverwendung wird eine Rotation über fünf physische Gewichtskopien gemessen. Beide Speicherformate überschreiten dabei gemeinsam viermal die gemeldete L2-Kapazität. Das erschwert einen Vergleich ausschließlich aus dem Cache, ersetzt aber keine Messung der tatsächlichen Cache-Misses. Kontrollen sind cuBLAS und ein eigener unkomprimierter Kern auf derselben Matrix. Energie stammt aus mindestens zwei Sekunden langen NVML-Zählerfenstern einschließlich GPU-Grundaufnahme.
Zwei Dekoder sparen Bytes, verfehlen aber das Leistungsziel
Der erste kombinierte Dekodier- und Rechenkern benötigt je nach geprüftem Fall 325,94 bis 718,86 µs. Der passende unkomprimierte Kern liegt bei etwa 117,61 bis 120,07 µs. Auch die gemessene GPU-Boardenergie steigt. Eine zweite Implementierung lädt Metadaten blockweise und dekodiert Wertepaare gemeinsam. Ihre vollständige Bitprüfung besteht ebenfalls.
Im separat ausgeführten Batch-8-Rotationsfall benötigt der verbesserte Dekoder 456,85 µs und 147,95 mJ Boardenergie. Der unkomprimierte Kern benötigt 120,08 µs und 39,89 mJ, cuBLAS 134,05 µs und 47,61 mJ. Die zweite Umsetzung verbessert den ersten komprimierten Pfad, bleibt jedoch ungefähr 3,8-mal langsamer als der passende unkomprimierte Kern. Host, Netz und Kühlung sind nicht Teil dieser Energiegrenze.
Was von der Hypothese übrig bleibt
Die Speicherersparnis ist nachgewiesen. Der Geschwindigkeits- und Energiegewinn der getesteten GPU-Dekodierung ist widerlegt. In einem ideal ausschließlich durch Gewichtsbytes begrenzten Fall entspräche die Reduktion rechnerisch nur etwa dem Faktor 1,31. Dekoderarbeit und andere Kosten verringern diesen Spielraum. Eine kleinere Darstellung trägt deshalb allein kein mehrfaches Systembeschleunigungsversprechen.
Ein spezieller Hardwaredekoder am Speicherausgang wäre eine neue Hypothese. Er müsste Metadatenzugriffe, Rückfallblöcke, Portbreite, Register, Timing und Energie gegen Raw-BF16 ausweisen. Bekannte verlustlose Kompressionsansätze gehören dabei zu den Referenzen. Die geprüfte GPU-Richtung wird vorerst beendet, während Format, Bitprüfung und negative Laufzeitergebnisse als reproduzierbarer Befund erhalten bleiben.
Konsequenz für den nächsten Entwurf
Die verlustlose Darstellung dokumentieren. Den getesteten GPU-Dekodierpfad wegen seines höheren Zeit- und Energiebedarfs aussortieren.